💬 最近在处理算法工具链相关问题时,我遇到了一个关于 InstanceBatchNorm 支持 的兼容性问题。
借这个机会,我也系统学习并梳理了各类 Normalization 算法 的原理、差异,以及在不同芯片(特别是地平线 BPU)上的支持情况。
本文算是一次总结与分享,也希望能为正在做模型部署、调优或量化的同学提供一个完整参考。
一、引论:为什么深度学习离不开 Normalization?
它的核心目标是——让特征分布更稳定、更容易被网络学习。
我们可以从两个层面理解它的重要性:
- 训练层面:
不同层输出的数值范围差异可能巨大,导致梯度消失或爆炸;
归一化后,网络在不同 batch 间分布更稳定,使得训练更快、收敛更稳。
- 推理层面:
保证特征在不同输入样本之间的可比性;
避免过度依赖特定输入分布,提高泛化能力。
简单一句话:Normalization 让网络“更好训练、更好泛化、更好部署”。
二、常见的几种 Normalization 算法
类型 | 归一化维度 | 是否依赖 Batch | 是否可学习参数 | 常见场景 |
|---|---|---|---|---|
BatchNorm | 跨样本、按通道 | ✅ 是 | ✅ γ, β | CNN 主干、分类任务 |
LayerNorm | 单样本、全通道 | ❌ 否 | ✅ γ, β | Transformer、NLP |
InstanceNorm | 单样本、单通道 | ❌ 否 | ✅ γ, β | 生成任务(GAN、风格迁移) |
GroupNorm | 单样本、分组通道 | ❌ 否 | ✅ γ, β | 小 batch CNN |
三、直观理解:它们到底在“归一化”什么?
操作 | 计算方式 | 特征 |
|---|---|---|
BatchNorm | 对整个 batch 内每个通道统计 mean/var | 稳定训练,加速收敛;但依赖 batch 大小 |
InstanceNorm | 每个样本、每个通道独立统计 | 去除样本风格差异,适合生成模型 |
LayerNorm | 每个样本的所有通道一起归一化 | 适合序列模型(Transformer) |
GroupNorm | 每个样本将通道分组后归一化 | 小 batch 时效果稳定 |
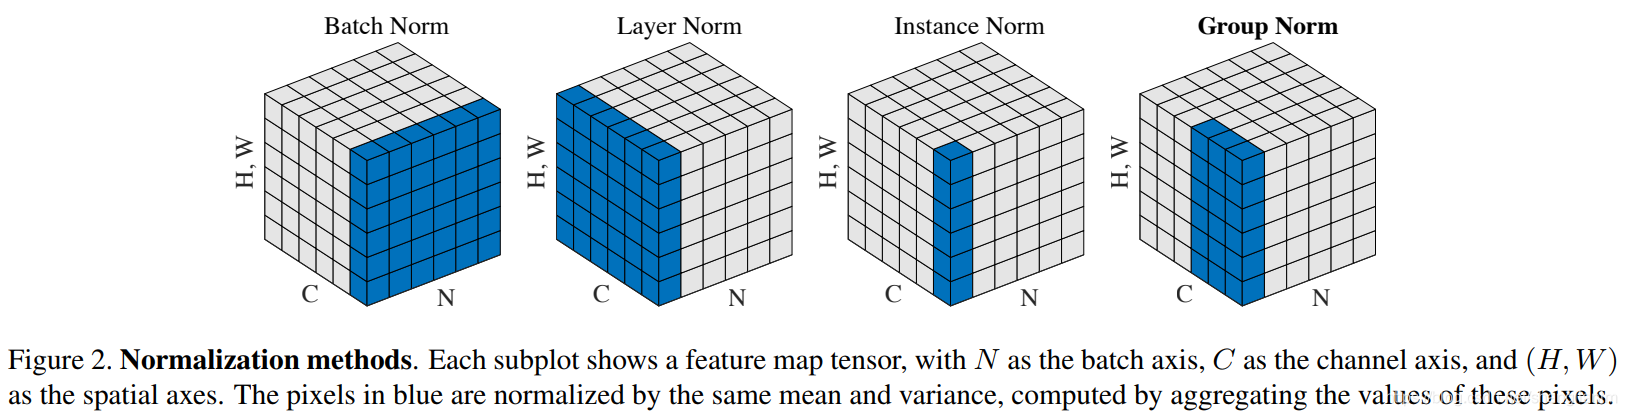 {{{width="800" height="auto"}}}
这些图形让我们更清楚地看到:
- BatchNorm 在 batch 维度上求统计量;
- LayerNorm / InstanceNorm / GroupNorm 则在样本内部求统计量;
- 本质区别在于 “均值与方差的计算维度”。
用一场考试举例(一个班级有很多人,每个人有不同的科目,每个科目有期中、期末等多场考试):
四、核心数学公式
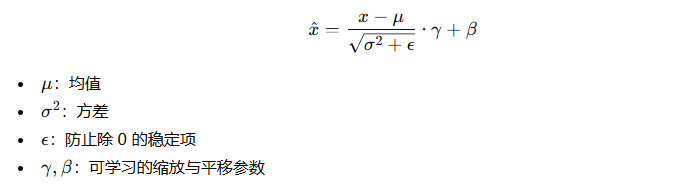
类型 | 均值方差的计算范围 |
|---|---|
BatchNorm | 全 batch 同通道 (N×H×W) |
LayerNorm | 单样本所有通道 (C×H×W) |
InstanceNorm | 单样本单通道 (H×W) |
GroupNorm | 单样本每 G 个通道一组 (G×H×W) |
五、差异分析与应用场景
维度 | BatchNorm | LayerNorm | InstanceNorm | GroupNorm |
|---|---|---|---|---|
归一化范围 | 跨 batch 的每通道 | 单样本所有通道 | 单样本单通道 | 单样本分组通道 |
依赖 batch size | ✅ 高度依赖 | ❌ 不依赖 | ❌ 不依赖 | ❌ 不依赖 |
训练收敛速度 | 🚀 极快 | ⚙️ 稳定 | 🧘 稳定 | 🚀 稳定快速 |
推理阶段一致性 | ❌(需移动平均) | ✅ 一致 | ✅ 一致 | ✅ 一致 |
量化友好性 | ⚠️ 一般(需特殊融合) | ✅ 友好 | ✅ 友好 | ✅ 友好 |
硬件加速可行性(BPU/NPU) | ✅ 优化良好 | ✅ 良好 | ⚙️ 中等 | ✅ 良好 |
典型任务 | 图像分类、检测 | Transformer、LLM | 风格迁移、GAN | 小 batch CNN |
PyTorch 模块 | nn.BatchNorm2d | nn.LayerNorm | nn.InstanceNorm2d | nn.GroupNorm |
六、BPU支持情况、应用场景 和 部署建议
🧠 支持情况
在模型部署到地平线芯片(如 J5/J6/NASH 系列)时,部分 Normalization 算子可直接在 BPU 上执行,部分需要由 CPU 代跑或替换。
Operator | BPU | CPU | 量化友好性 | 备注 |
|---|---|---|---|---|
BatchNormalization | ✅ | ✅ | 推荐 | 支持融合到 Conv,可减少额外计算, 性能最佳 |
GroupNormalization | ✅ | ✅ | 中等 | 原生支持,对 batch 小的网络量化友好 |
InstanceNormalization | ✅ | ✅ | 一般 | 支持良好,适合生成模型 |
LayerNormalization | ✅ | ✅ | 稳定 | 支持常见形式(Transformer中常见) |
LpNormalization | ❌ | ❌ | 不支持 | 暂不支持 |
MeanVarianceNormalization | ❌ | ❌ | 不支持 | 暂不支持 |
RandomNormal / NormalLike | ❌ | ❌ | 不支持 | 属于随机张量生成,非推理阶段算子 |
StringNormalizer | ❌ | ❌ | 不支持 | 文本预处理相关,CPU侧处理 |
🔧 部署建议
场景 | 推荐归一化方式 | 理由 |
|---|---|---|
图像分类、检测(大 batch) | BatchNorm | 稳定、成熟、融合好 |
小 batch 训练 | GroupNorm | 不依赖 batch 统计 |
Transformer / NLP / LLM | LayerNorm | 适合序列特征 |
图像生成(GAN/风格迁移) | InstanceNorm | 去除个体风格差异 |
BPU 量化部署 | Conv+BatchNorm 融合 | 性能最优、量化友好 |
🏁 应用总结
七、PyTorch 代码示例
这些算子在 地平线工具链 中均能正确识别,部分可自动融合。
八、常见注意事项
BatchNorm 推理模式需固定统计量
- InstanceNorm 在小 batch 下稳定性好(不依赖 batch)
LayerNorm 在序列模型(Transformer)中最常见
GroupNorm 在小 batch 的 CNN 中常替代 BatchNorm
- 量化部署前会融合或替换 BN,否则量化后 scale 不一致会带来偏差
- inplace 运算注意:Norm 层一般不应 inplace 操作,否则反向传播会报错。
九、结语
它是一块性能与稳定性的基石,理解它不仅能优化模型训练的稳定性,更能在 地平线 BPU 平台 上充分发挥算力潜力。
🌟 一句话总结:
让每一次归一化,都为模型的性能与稳定性加分。