该示例为参考算法,仅作为在J6上模型部署的设计参考,非量产算法
简介
PETR 是一个 3D 目标检测模型,它把 3D 位置引入 Transformer 解码:通过 3D 位置编码将图像特征与 3D 空间位置关联,Transformer 的 query 直接与 3D 位置编码特征交互预测 3D 检测框,无需显式 BEV 特征构造。本文将介绍 PETR 在地平线 J6 平台上的优化部署。
性能精度指标
PETR模型配置及指标:
dataset | backbone | input_shape | num_query | NDS(浮点) | NDS(定点) | mAP(浮点) | mAP(定点) | J6M-Latency | J6M-FPS |
Nuscenes | Eficientnet-B3 | 6x3x512x1408 | 900 | 0.3881 | 0.3799 | 0.3031 | 0.2958 | 33.13 | 30.51 |
注:
建议使用小分辨率对模型性能会更友好:例如输入为[4,3,480,640]时,性能表现为双核62FPS,以实际需求为主
Nuscenes 数据集官方介绍:nuScenes
模型介绍
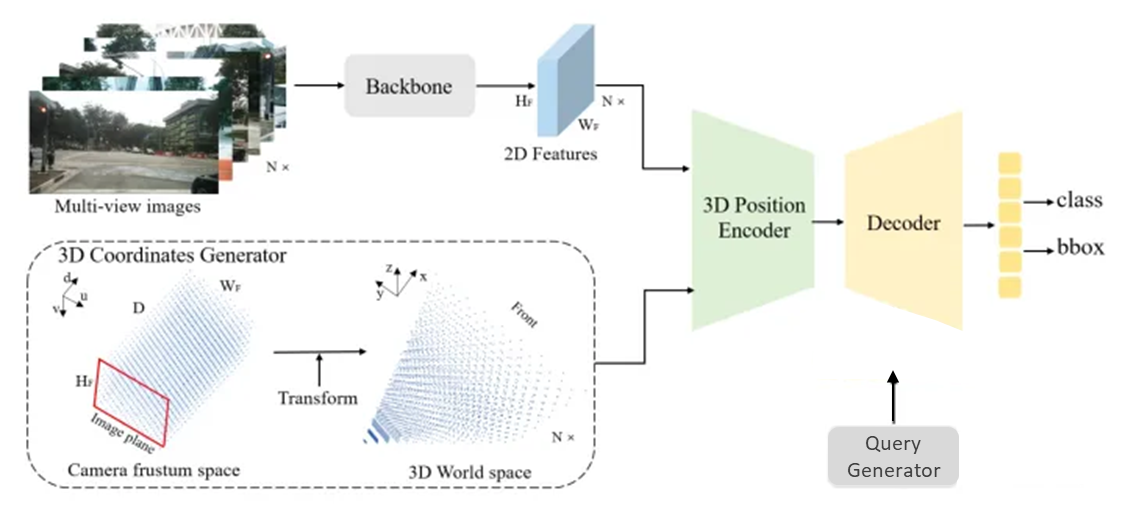
PETR 模型结构图
PETR模型主要包括以下部分:
改动点说明
替换了backbone,由resnet50的backbone替换回了同级别的efficientnet b3
Decoder部分,query由原来的3维(1,900,256)/ NQC 改成了(1,256, 4, 128)/NCHW,逻辑实现上与公版一致
使用1x1的卷积替换了公版的linear,减少transpose和reshape的操作
LayerNorm2d为地平线内部自实现算子,性能更高
img_encoder
来自6个view的image作为输入通过共享的backbone(efficientnet-b3)输出经过encoder后的feature,feature_shape为(6*B,C,1/2H,1/2W)。encoder即对多个view的img_feature 做特征提取,过程见下图:
head
由上图可知,PETR的head层完成特征提取和生成预测目标的全流程,通过生成的3D coords融合位置编码生成成pos_embed ;根据num_query生成可学习的query_embed;再将2D feature 做1x1的conv映射,将以上做为transformer解码器的输入。经由transfomer层做注意力计算生成target,通过cls、reg分支得到预测类别和位置。
2D-Features 映射
将2D feature使用1x1的卷积映射:
3D Coords 生成
生成位置编码
3D PE 生成
融合位置编码
为了得到位置信息,将位置信息添加到PE中,融合方式为add
生成query 编码
生成可学习的reference_points(queries),转换为3D的query,然后将其编码(conv+relu+conv),最终形成query_embed。
transformer层
完成2D features到3D features的 特征转换,该部分会在 PETR Transformer 章节详细说明。
预测层
预测分支分为reg_branch和cls_branch,PC端在head层完成根据reference_points和reg计算bbox过程。
PETR Transformer
由DecoderLayer构成:
Decoder层数为6层,上一层的输出为下一层的输入,每层主要完成两个注意力计算:在query之间做self-attention,再和图像特征之间做cross-attention。整理流程如下图:
Self Attention
该层为query之间的4维自注意力层,q=k,避免不同的queries 预测同一个目标。
CrossAttention
地平线部署说明
PETR 模型在地平线 J6 上部署的优化主要集中在 backbone 替换、Decoder 维度调整、conv 替换 linear 以及自研 LayerNorm2d 等方面,具体改动见「改动点说明」章节。下面将精度优化对应的改动点以及量化配置依次说明。
精度优化
浮点精度
量化精度
注:早期版本中校准使用 MSEObserver(40 steps),最新接口在校准阶段改用 HistogramObserver(200 calib steps / 800 frames),histogram 使用完整样本集放置裁剪阈值,精度更优;QAT/deploy 阶段通过 fix_scale=True 在 calib 值上冻结激活 scale(需 horizon-plugin-pytorch >= 3.4.1)。
总结与建议
训练建议:
建议使用小分辨率对模型性能会更友好,例如输入为[4,3,480,640]时性能表现为双核62FPS,以实际需求为主。
浮点训练采用 AdamW + CosineAnnealingLrUpdater(warmup_lr_ratio=1/3),QAT 阶段采用 StepDecayLrUpdater 对量化精度更友好。
Calibration 建议使用 HistogramObserver(200 calib steps),精度优于 MSEObserver。
部署建议:
backbone 推荐使用 efficientnet-b3,在保证精度同级的同时更利于 J6 部署。
使用1x1的卷积替换公版的 linear,减少 transpose 和 reshape 操作,提升部署性能。
优先采用地平线自实现的 LayerNorm2d 算子,性能更高。
在注意力机制中存在一些 matmul 等 ElementWise 操作,对量化敏感的算子(如 self_attns / corss_attn 的 matmul)可配置 int16 输出以保障量化精度。
本文通过对PETR在地平线征程6上量化部署的优化,使得模型在J6M上得到latency为33.13ms、FPS为30.51的部署性能,同时,通过PETR的部署经验,可以推广到其他 transformer-based 3D 检测模型的部署中。
附录
- 参考算法(modellabs)官网:https://oe.horizon.auto/labs
- 论文:PETR
公版模型代码:https://github.com/megvii-research/PETR
- Nuscenes 数据集官方介绍:nuScenes