该示例为参考算法,仅作为在J6上模型部署的设计参考,非量产算法
简介
多目标跟踪是在视频序列的每一帧中定位所有的目标并确定它们的移动轨迹的任务。因为每帧中的目标都可能因为环境的变化而被遮挡,而且跟踪器要想进行长期跟踪或者低帧率的跟踪是比较困难的,所以多目标跟踪是极具挑战性的任务。MOTR(Multiple-Object Tracking with Transformer)能够学习建模目标的长时间变化,隐式地进行时间关联。基于Transformer和DETR,MOTR引入了track query这个概念,一个track query负责建模一个目标的整个轨迹,它可以在视频帧间传递和更新,从而无缝地完成目标检测和跟踪任务。本文将介绍 MOTR 在地平线 J6 平台上的优化部署。
性能精度指标
MOTR模型配置:
数据集 | Input shape | backbone | head | post-process | 跟踪目标最大数量 | 检测类别 |
mot17 | 1x3x800x1422 | efficientnetb3 | MotrHead | MotrPostProcess | 256 | 行人 |
性能精度表现:
J6M-latency/ms | 性能J6M-FPS | MOTA | ||
浮点 | 量化 | |||
8.03 | 128.68 | 0.5842 | 0.5767 |
注:MOT17数据集官方介绍:MOT17
模型介绍
MOTR的输入为图像序列,输出为跟踪目标的位置信息和类别信息。MOTR的总体架构和过程如下图所示,主要由以下部分组成:

- Enc:由backbone(efficientnetb3)和Deformable DETR encoder组成,用来提取每帧图像的特征;
- Dec:由Deformable DETR decoder组成,用来生成bounding box 预测的隐藏状态。对于第一帧,不存在跟踪查询$$q_{tr$$,因此只将固定长度的检测查询$$q_$$和手工生成的fake跟踪查询输入到Dec中;对于连续帧,模型会将来自前一帧的跟踪查询和可学习的检测查询输入到Dec中。更新检测查询和跟踪查询的过程如下所示:
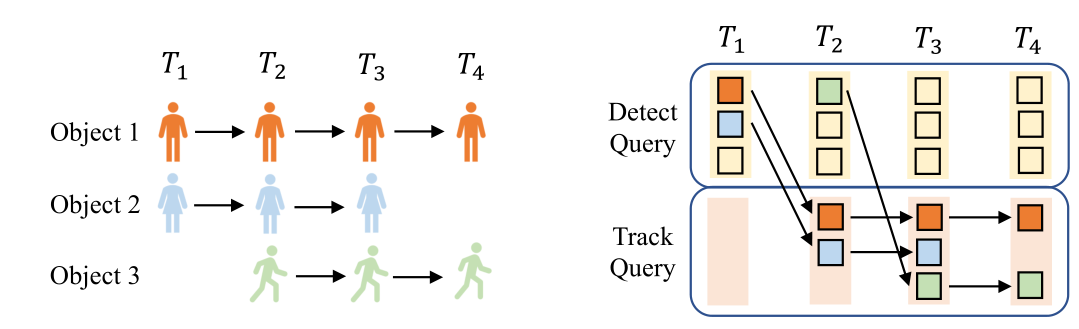
Track Query是动态更新的,而且长度是可变的。首先将Track Query初始化为空,然后使用Detect Query检测新生目标,将所有检测到的目标的隐藏状态连接起来,从而生成下一帧的Track Query,终止目标的Track Query则将从Track Query集中删除。
- Query Interaction Module(QIM):QIM将Dec生成的box的隐藏状态作为输入,并为下一帧生成跟踪查询。QIM包括目标进出机制和时间聚合网络(Temporal Aggregation Network,TAN)。目标进出机制用来解决新生目标和终止目标的问题;TAN增强了时间关系建模,并为跟踪目标提供上下文先验。
改动点说明
相对于公版实现,地平线对MOTR的模型结构和训练策略做了如下优化:
模型结构优化
将backbone从ResNet50更换到efficientnetb3,兼顾模型精度和推理性能;
优化query维度,模型中将query全部由二维优化为4维进行计算,便于性能提升;
模型中的linear全部替换为conv2d,便于性能提升;
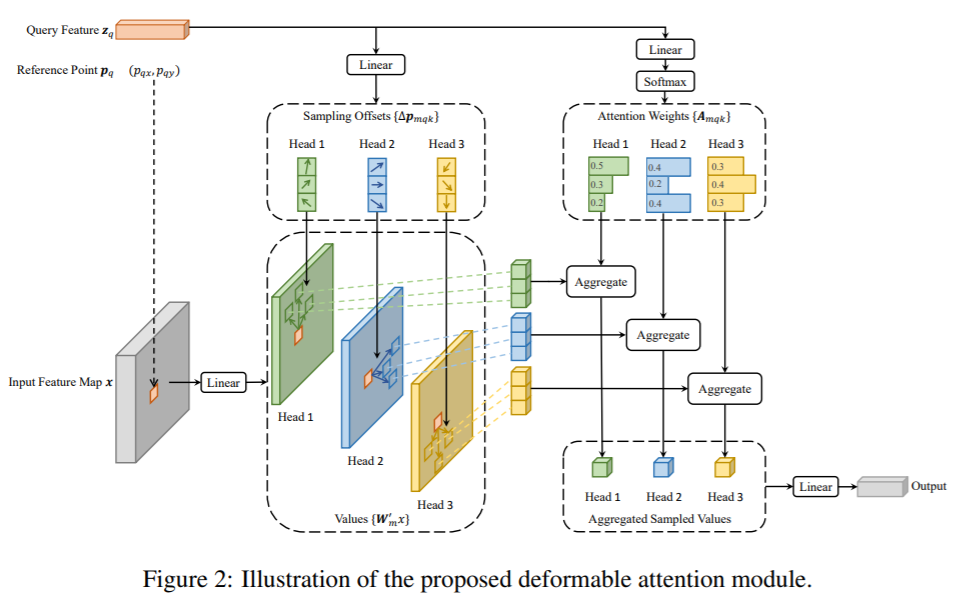
deformable attention优化:
输入采用四维的数据,避免了flatten+reshape的重复计算;
将每个注意力头的采样点数量由4个减少到1个,并且用sigmoid替换softmax,便于性能提升(精度基本上不变);
Track query个数由300降低到256,便于性能提升;
引入padding query和mask query,解决动态shape问题。
训练策略优化
- 引入了DAB-DETR的anchor-box,直接将box的坐标作为queries输出到DeformableTransformer的解码器中,加速模型收敛和提升精度;
- 引入了DINO的look forward twice,利用后一层的改进的box信息校正前一层的box预测,优化梯度传播,提升预测精度。
Backbone
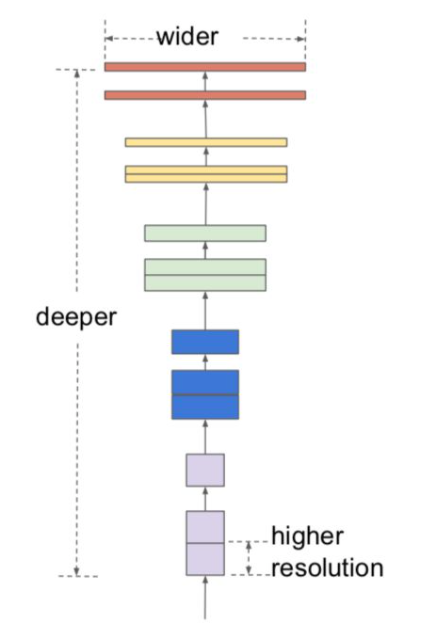
MOTR参考算法采用与硬件比较友好的efficientnetb3作为backbone来提取图像多尺度特征,提升了模型的精度。efficientnetb3的网络结构如下所示:
MotrHead
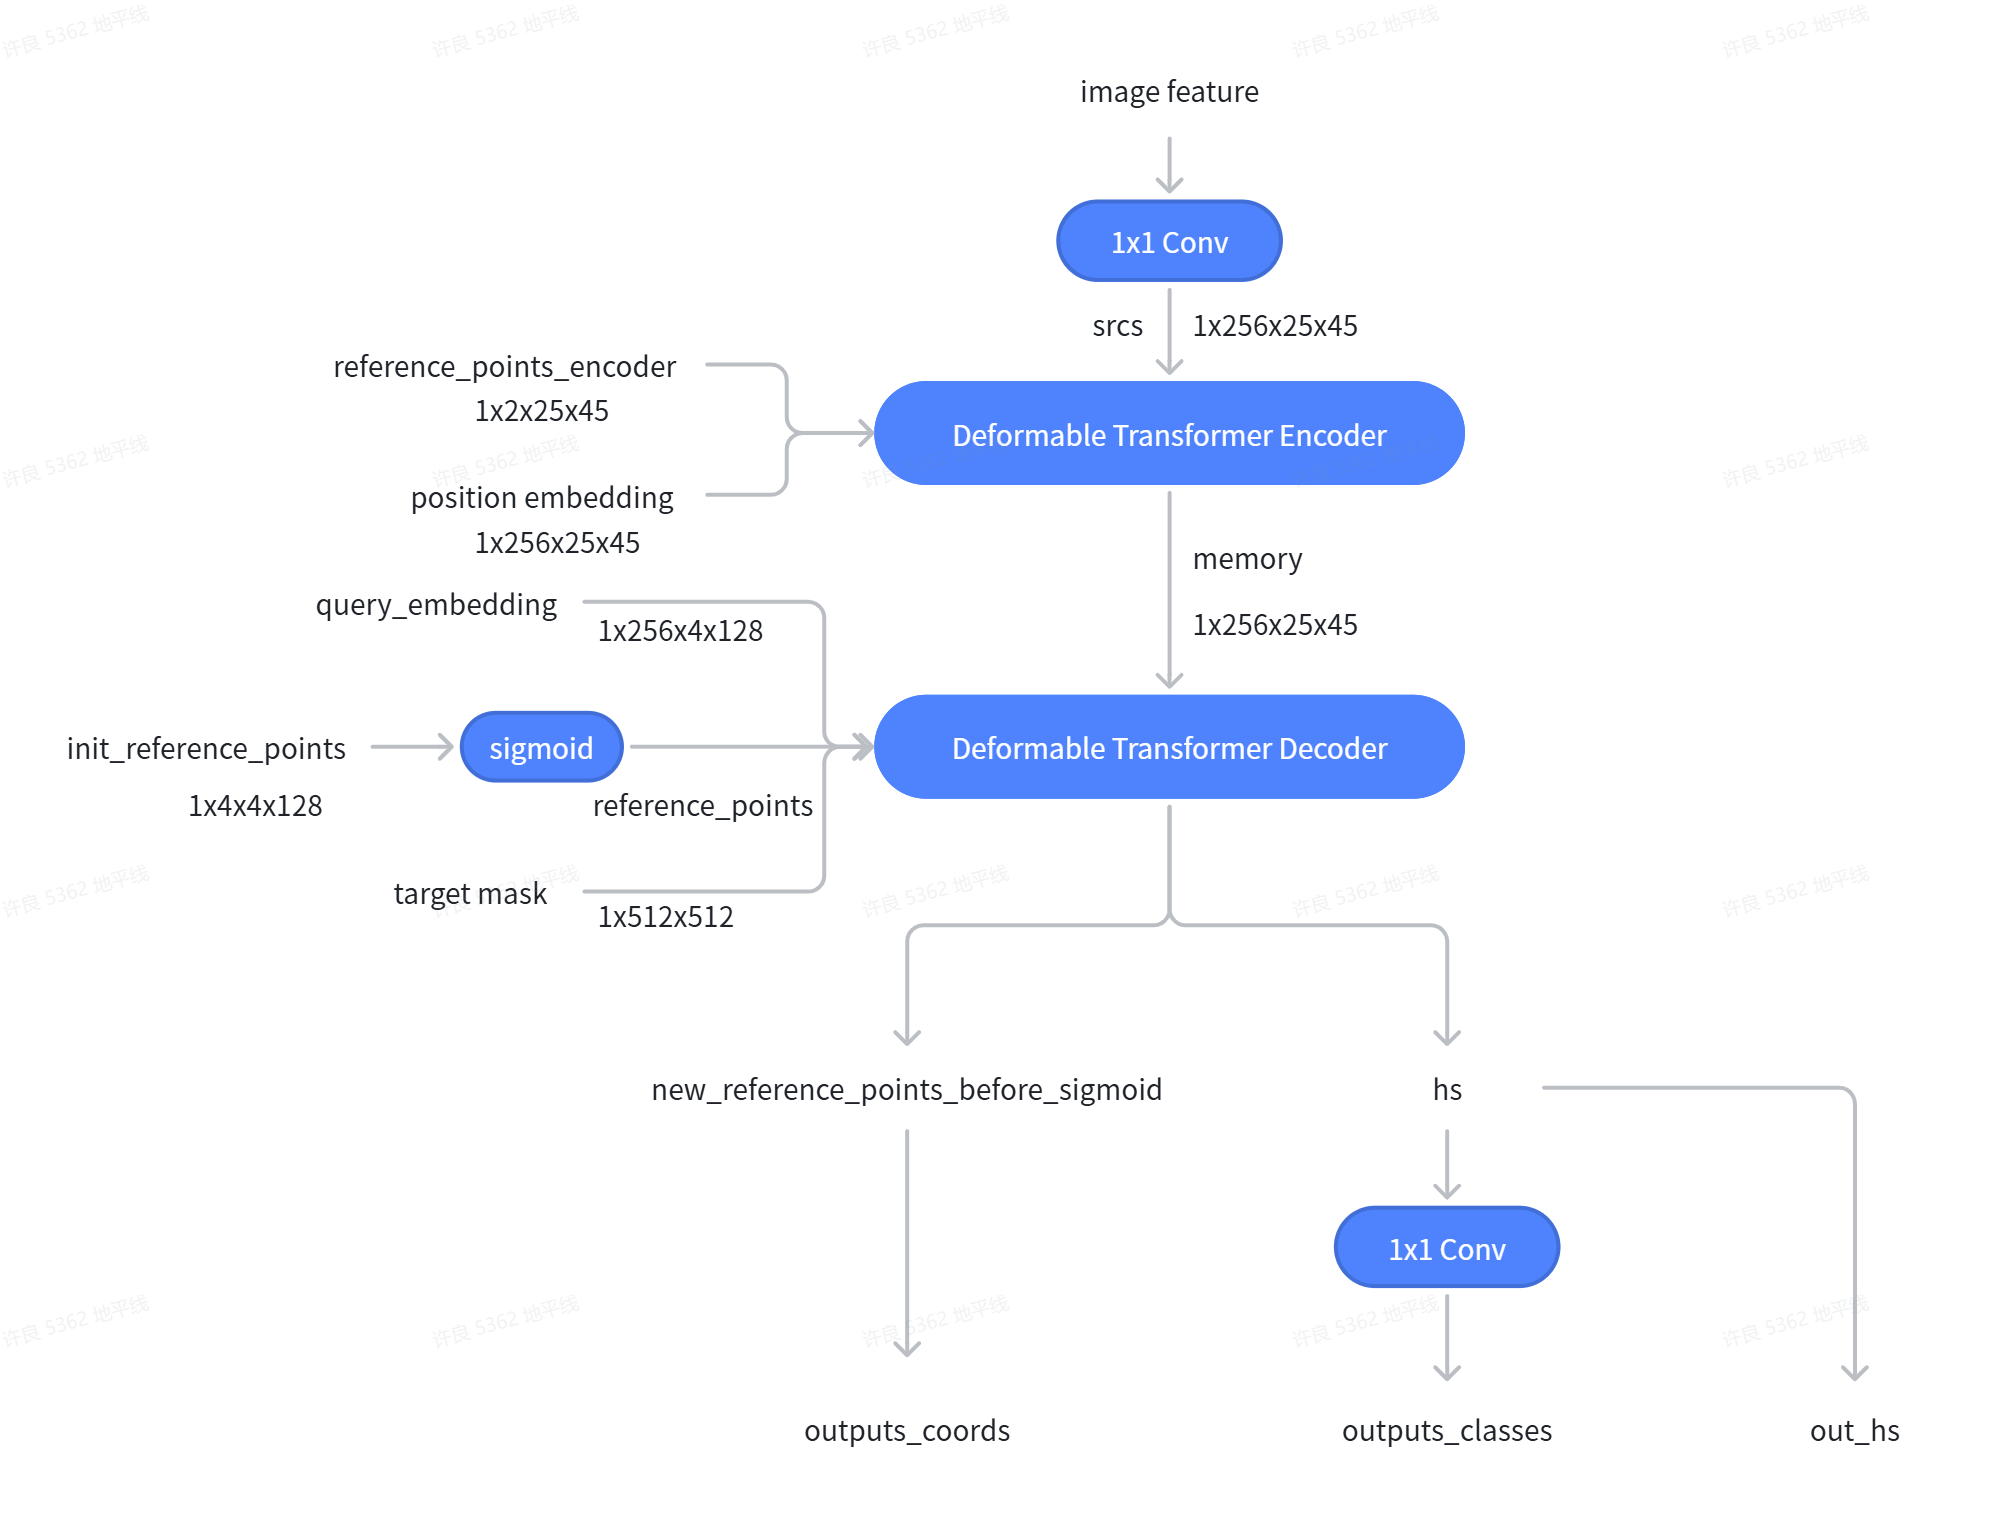
MOTR通过efficientnetb3和Deformable Transformer Encoder提取图像序列特征。对于第一帧图像,由于不存在跟踪查询,所以将固定长度的可学习检测查询和padding后的fake跟踪查询输入到Deformable Transformer Decoder。对于连续帧,将来自前一帧的跟踪查询和可学习的检测查询输入到解码器中,这些查询与解码器中的图像特征交互,生成用于边界框预测的类别classes、坐标coords和hs,然后输入到查询交互模块(QIM)中,来生成下一帧的跟踪查询。
Track instance 初始化
对于首帧图像,我们生成了值全为0的track instance用于目标padding,初始化过程如下所示:
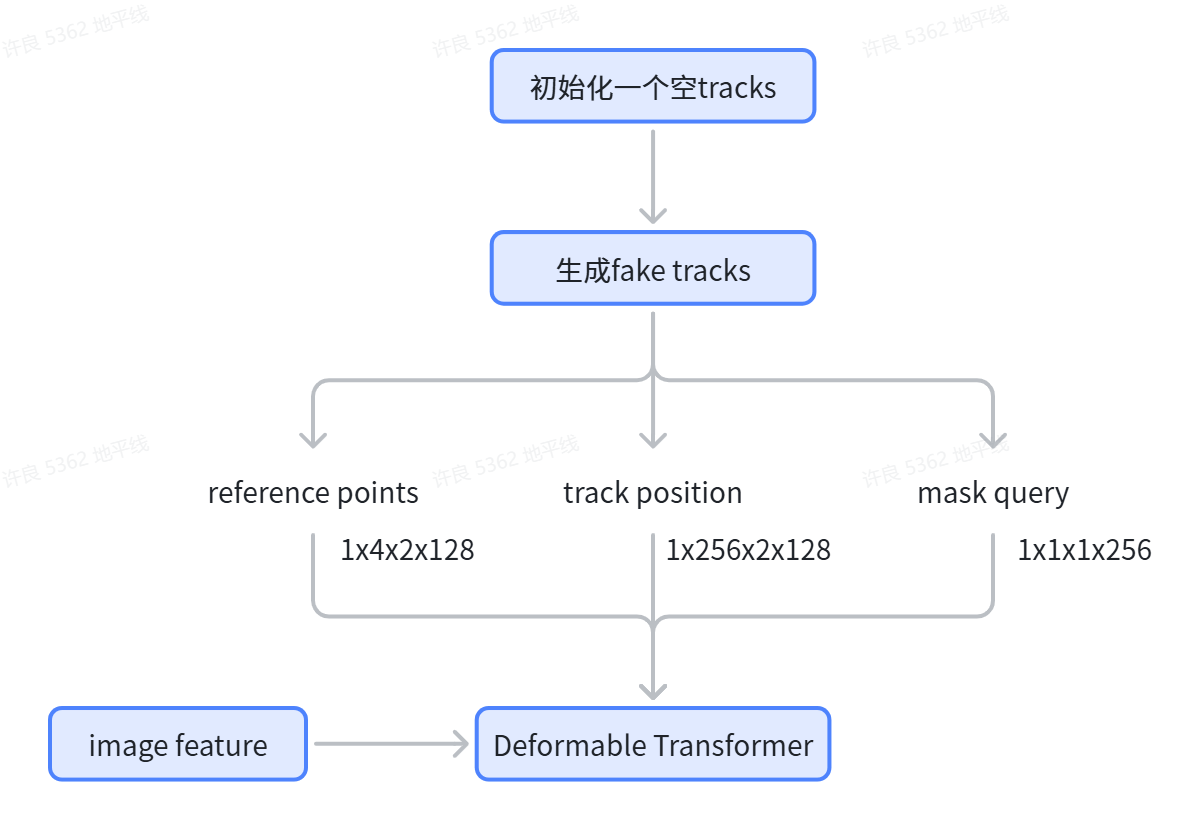
相关代码如下所示:
Deformable Transformer Encoder
Deformable Transformer Encoder的作用是提取一帧图像的特征。它的输入是backbone 提取的图像特征、参考点reference points和位置编码position embedding。
如下为结构示意图:
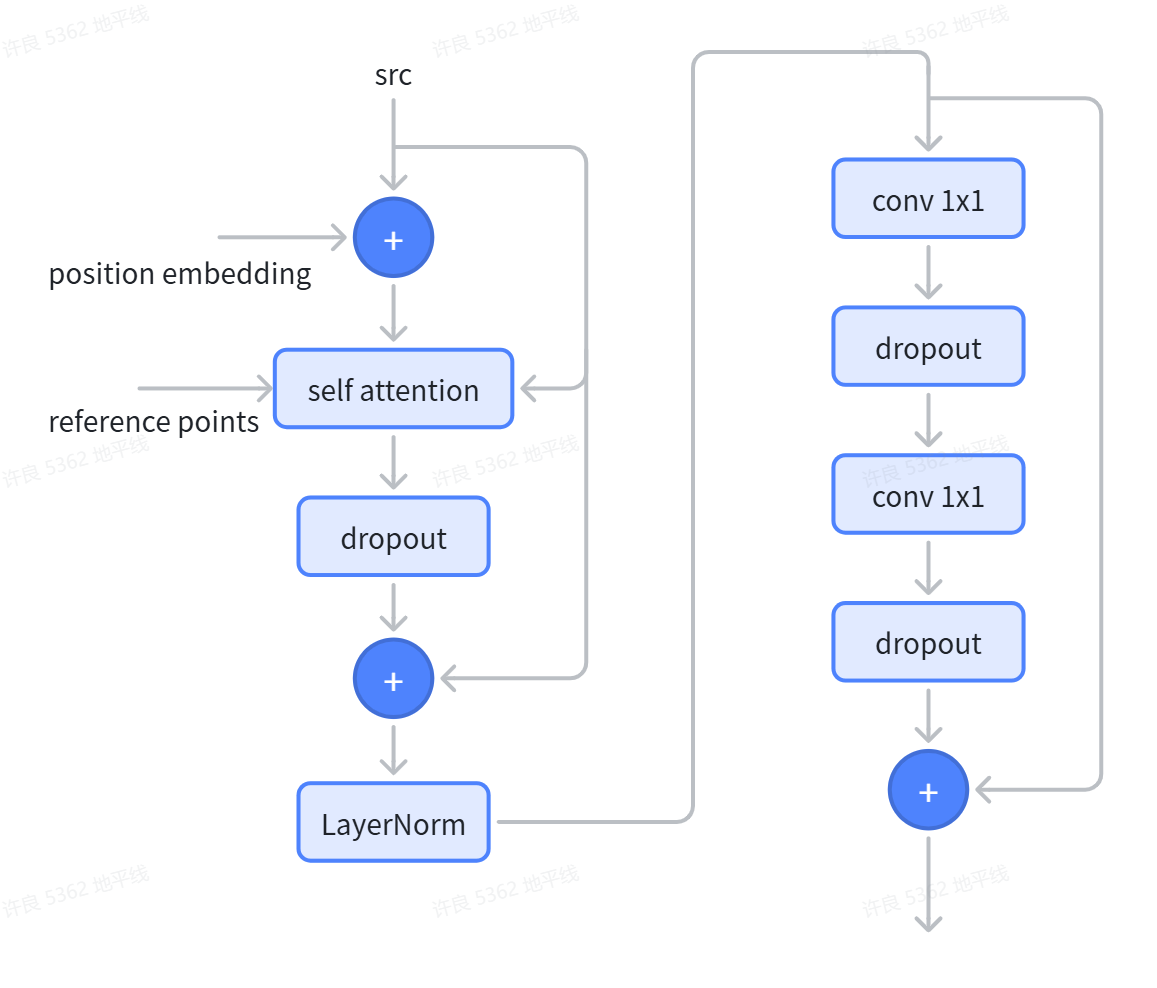
相关代码:
Deformable Transformer Decoder
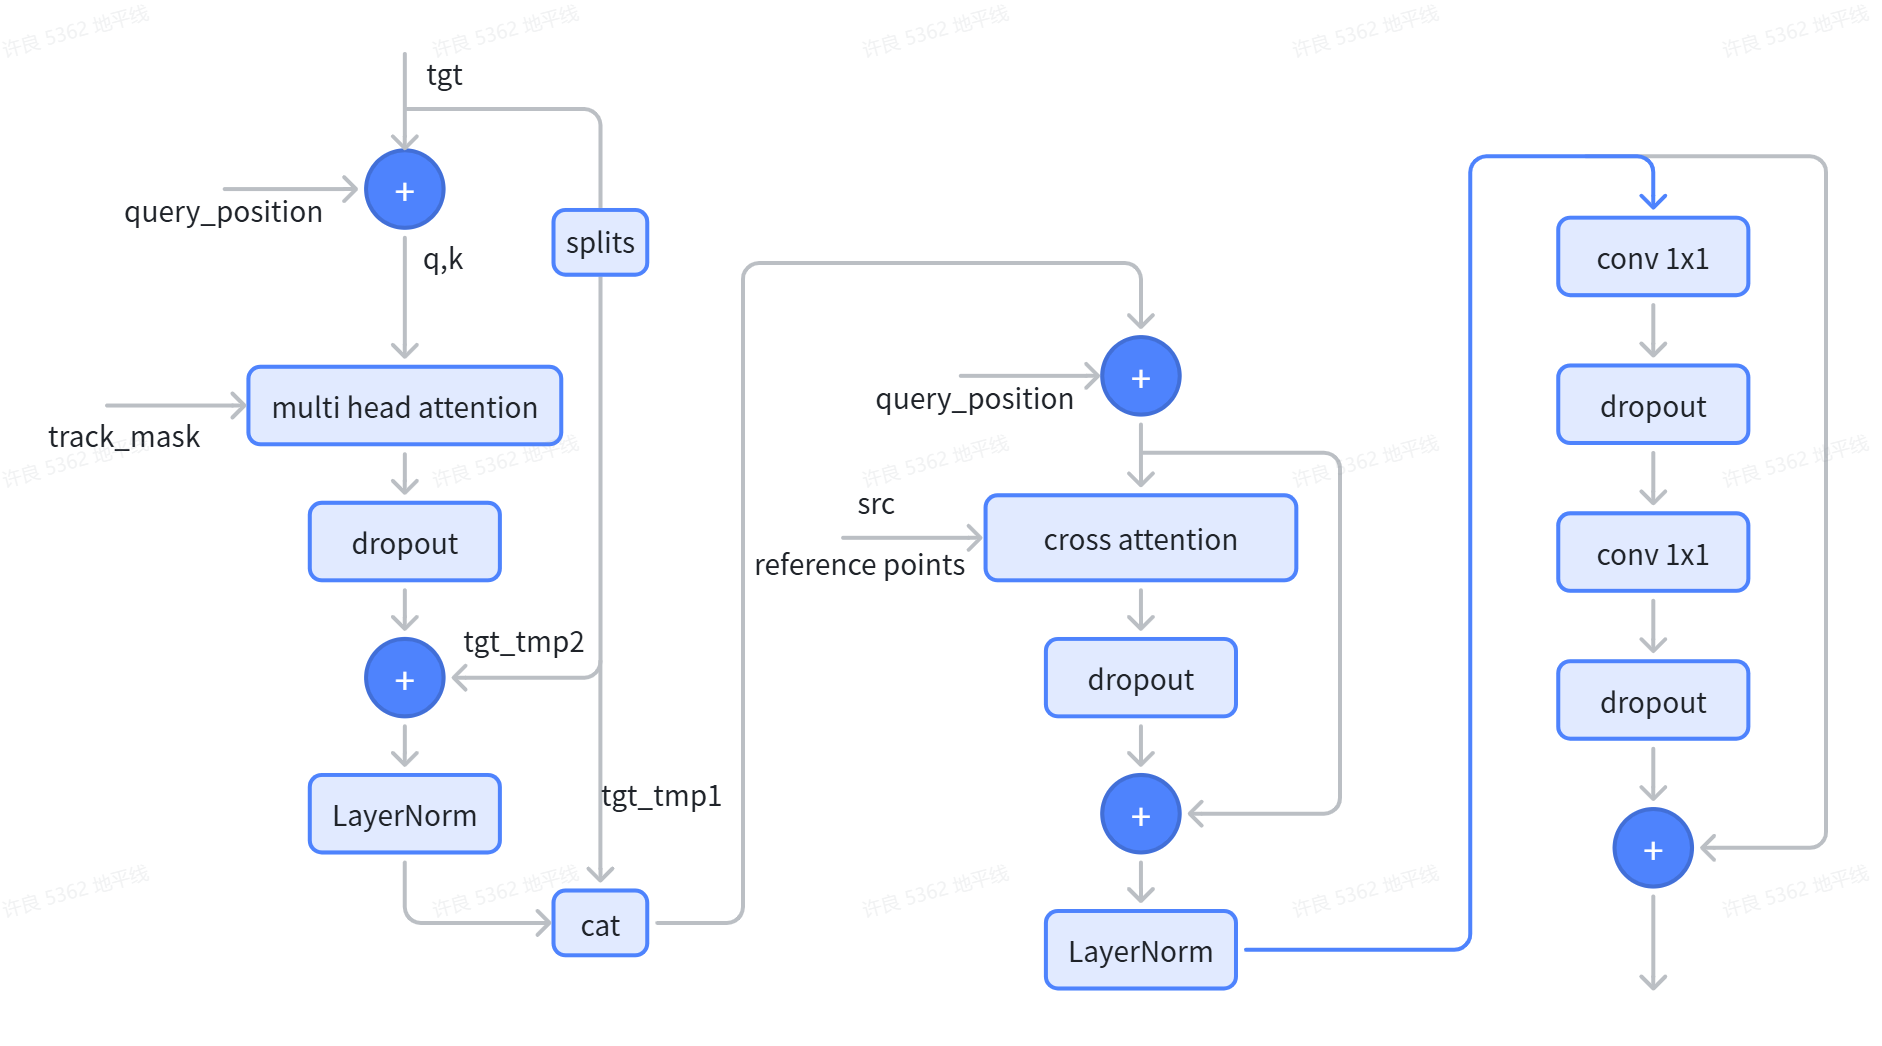
相关代码如下所示:
Post Process
MotrHead输出了目标的类别信息classes、bbox信息和decoder的中间结果hs,将这些结果进行处理后,然后再输入到QIM模块,相关过程如下所示:
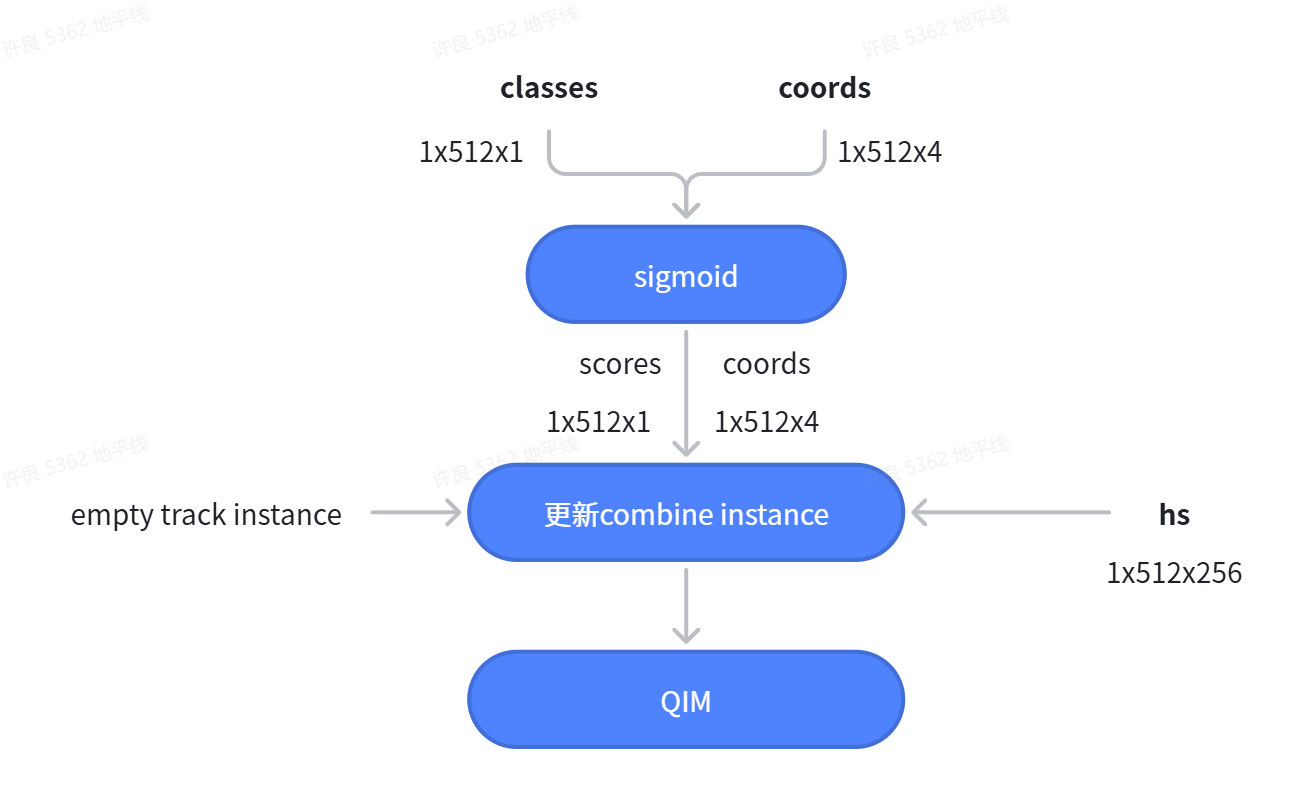
相关代码如下所示:
查询交互模块(query interaction module,QIM)包括目标进出机制和时间聚合网络(TAN)。QIM的结构如下图所示:
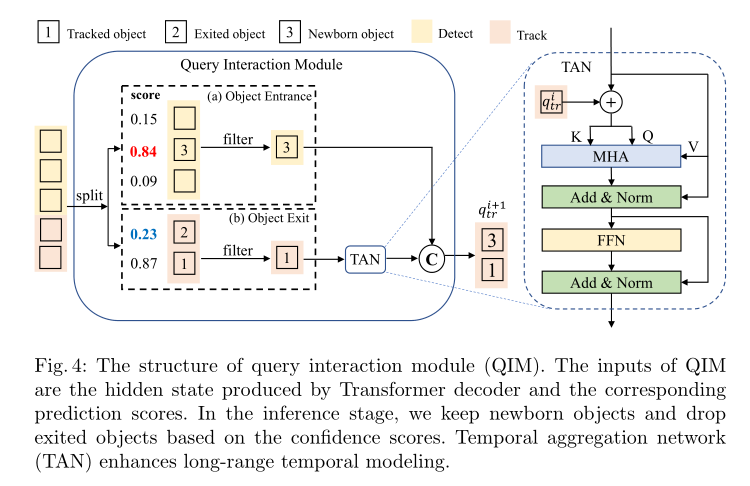
目标进出机制
视频帧序列中的一些目标可能在中间帧出现或消失。MOTR中处理新生目标和终止目标的方式是对于任何帧,跟踪查询都与检测查询连接,并输入到Transformer解码器,从而产生隐藏状态(如上图的左侧)。在训练过程中,如果匹配的目标在Ground Truth中消失,或者预测的边界框和目标之间的IoU低于0.5的阈值,则去除终止目标的隐藏状态。为了进行推理,我们使用预测的分类分数score来确定新生目标的出现和被跟踪目标的消失。对于目标查询,保留分类分数高于阈值的预测,同时删除其他隐藏状态。
对应代码:
对于跟踪查询,删除连续5帧的分类分数低于阈值的预测,同时保留其他隐藏状态,对应代码如下所示:
代码路径:
heal/models/task_modules/motr/post_process.py
heal/models/task_modules/motr/motr_utils.py
时间聚合网络
MOTR在QIM中引入了时间聚合网络(TAN),以增强时间关系建模,并为被跟踪目标提供上下文先验。如上图所示,TAN的输入是被跟踪目标(目标“1”)的filter隐藏状态,还收集了来自最后一帧的跟踪查询,用于时间聚合。TAN是一个改进的Transformer解码器层。最后一帧的跟踪查询和filter后的隐藏状态相加,成为多头自注意力的key和query。
相关代码如下所示:
地平线部署说明
MOTR 模型在地平线 J6 上部署的优化主要集中在 backbone 替换、query 维度调整、conv 替换 linear、deformable attention 采样点与 softmax 优化等方面,具体改动见「改动点说明」章节。下面将精度优化对应的改动点以及量化配置依次说明。
精度优化
浮点精度
训练策略上引入了 DAB-DETR 的 anchor-box(直接将box坐标作为queries输出到解码器,加速收敛、提升精度)与 DINO 的 look forward twice(利用后一层改进的box信息校正前一层box预测,优化梯度传播)。
量化精度
注:早期版本中这些 int16 配置写在各模块的 set_qconfig 方法内,最新接口已统一迁移到 qconfig.py 的 ModuleNameTemplate,量化配置不再依赖模型内部的 set_qconfig。QAT 阶段的激活 scale 冻结由 fix_scale=True 完成(需 horizon-plugin-pytorch >= 3.4.1)。
总结与建议
训练建议:
引入 DAB-DETR 的 anchor-box 与 DINO 的 look forward twice,可加速收敛、提升精度并优化梯度传播。
对于跟踪任务,建议在量化训练适当增加 epoch,并采用 StepDecayLrUpdater 策略对量化训练精度更友好。
- 校准建议使用 HistogramObserver,并在 QAT/deploy 阶段通过 fix_scale=True 冻结激活 scale,避免多帧序列跟踪漂移。
部署建议:
backbone 推荐使用 efficientnetb3,兼顾精度与推理性能;模型中的 linear 全部替换为 conv2d,便于性能提升。
deformable attention 建议采用四维输入(避免 flatten+reshape)、减少采样点数量并用 sigmoid 替换 softmax,在精度基本不变的前提下提升性能。
引入 padding query 和 mask query 解决动态 shape 问题;Track query 个数可按需降低(如 300→256)以提升性能。
- 量化时对 decoder reference_points 路径用 freeze=True 锁定 int16,防止 FuseConvAddTemplate 降级导致 hbir 输出 coords 范围塌缩与跟踪漂移。
本文通过对MOTR在地平线征程6上量化部署的优化,使得模型在J6M上得到latency为8.03ms、FPS为128.68的部署性能,MOTA 浮点/量化分别为0.5842/0.5767,同时,通过MOTR的部署经验,可以推广到其他 transformer-based 多目标跟踪模型的部署中。
附录
- 参考算法(modellabs)官网:https://oe.horizon.auto/labs
- 论文:MOTR
- MOT17数据集官方介绍:MOT17