
【模型部署那些事】J6 量化路线怎么选:PTQ 还是 QAT?
模型从训练环境走向端侧部署,量化几乎是绕不开的一步。
在 J6 上也是如此。模型量化不仅关系到最终的模型精度,也直接影响模型在 BPU 上的执行性能。
实际部署过程中,我们通常同时关注两个目标:
Accuracy:量化后的模型精度能否满足业务要求
Performance:模型在 J6 上的推理性能能否满足部署要求
围绕这两个目标,目前常见的两条量化路线分别是:
- PTQ(Post Training Quantization):训练后量化
- QAT(Quantization Aware Training):量化感知训练
很多刚开始接触模型量化的开发者都会有一个疑问:
PTQ 和 QAT 到底应该怎么选?是不是 QAT 的效果一定比 PTQ 好?
实际上,PTQ 和 QAT 并不是简单的“基础版”和“高级版”关系。
对于一个具体模型,真正应该考虑的是:
哪一种量化方式能够以合理的工程成本,同时满足 J6 上的精度和性能要求?
本文就围绕这个问题展开。
一、PTQ 和 QAT 基本概念
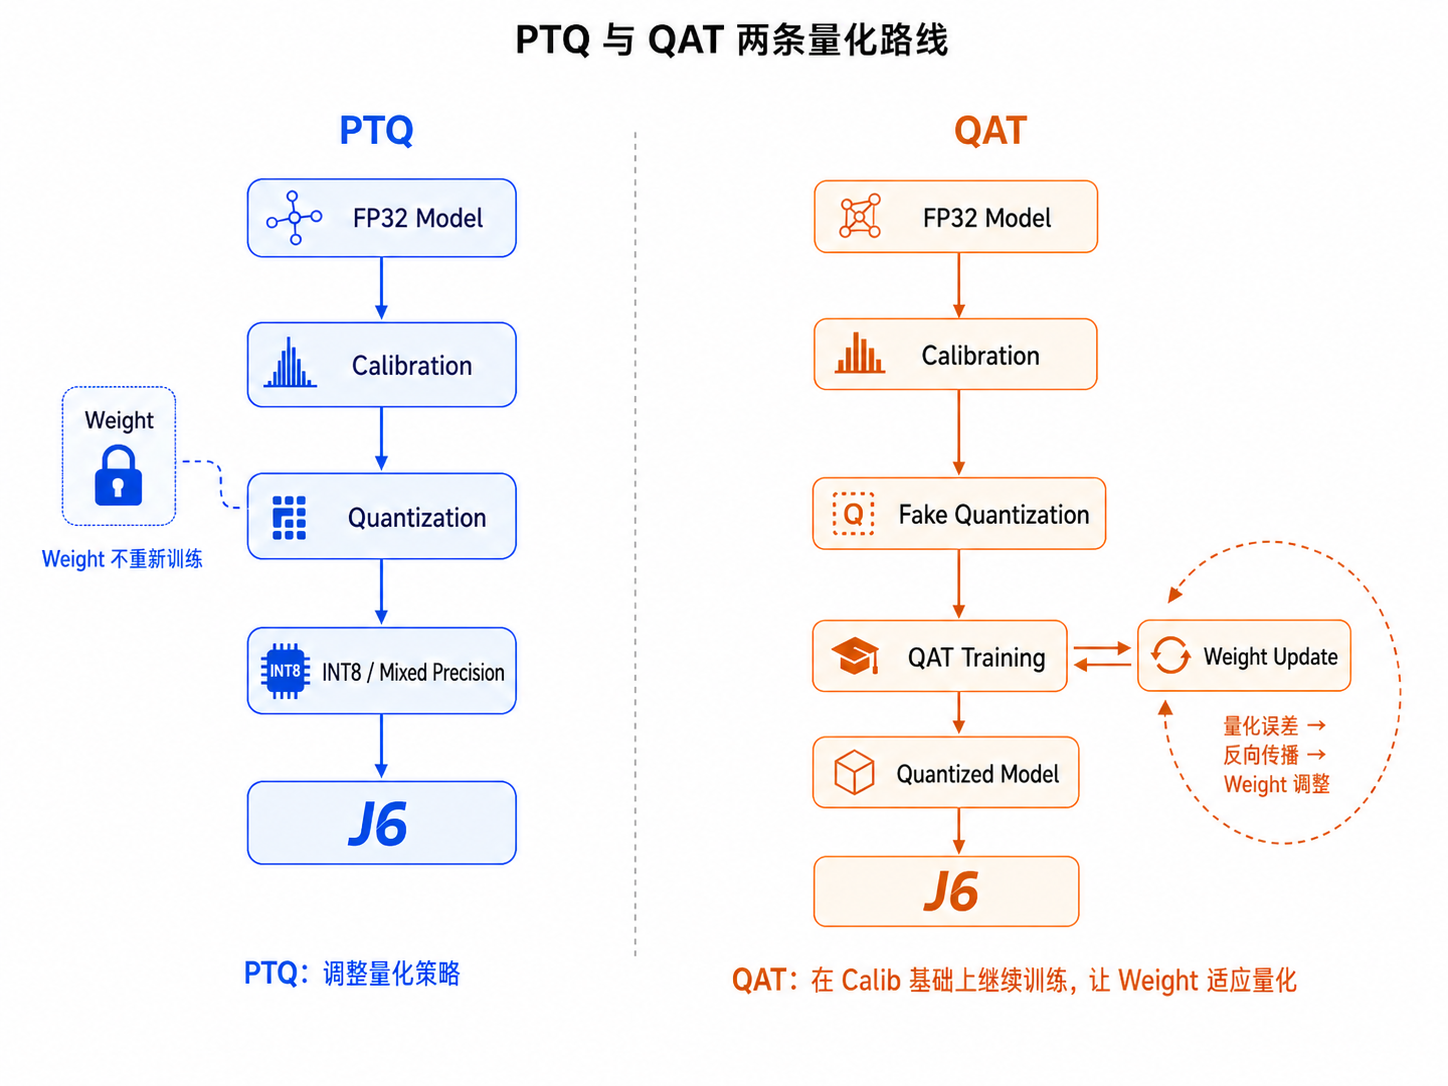
1.1 什么是 PTQ
顾名思义,PTQ 是在浮点模型已经完成训练之后,再对模型进行量化。
一个典型的 PTQ 流程可以简单理解为:
PTQ 最大的特点就是:
不需要重新训练原始模型。
在 PTQ 过程中,通常会准备一批具有代表性的 Calibration 数据,让这些数据经过模型前向推理,从而统计模型各层 Activation 的数值分布,并据此确定相应的量化参数。
这里有一个容易产生误解的地方:
PTQ 并不是不量化 Weight。
实际上,PTQ 中通常同时涉及:
Weight Quantization
Activation Quantization
真正的区别在于:
PTQ 不会通过反向传播重新更新原始 Weight。
1.2 什么是 QAT
和 PTQ 最大的不同在于:
QAT 会把量化误差带入模型训练过程。
一个简化的 QAT 流程如下:
QAT 中通常会通过 FakeQuant 等伪量化机制,在浮点训练过程中模拟真实量化时可能产生的:
截断误差
舍入误差
数值范围限制
Weight Quantization Error
Activation Quantization Error
这些误差会直接参与模型的前向计算。
随后通过:
模型参数可以在训练过程中逐渐适应量化带来的误差。
因此,PTQ 和 QAT 最本质的区别可以概括为:
PTQ 是在模型参数基本固定的情况下寻找合适的量化方案;QAT 则进一步允许模型参数通过训练主动适应量化。
二、PTQ 与 QAT 对比
虽然 PTQ 和 QAT 的实现方式不同,但是两者最终的目标其实完全一致:
在保证模型精度的情况下,尽可能获得更好的 J6 BPU 执行性能。
因此,在评价一个量化方案时,不能只看量化之后模型的 Accuracy。
真正部署到芯片之后,我们至少需要同时考虑:
比如:
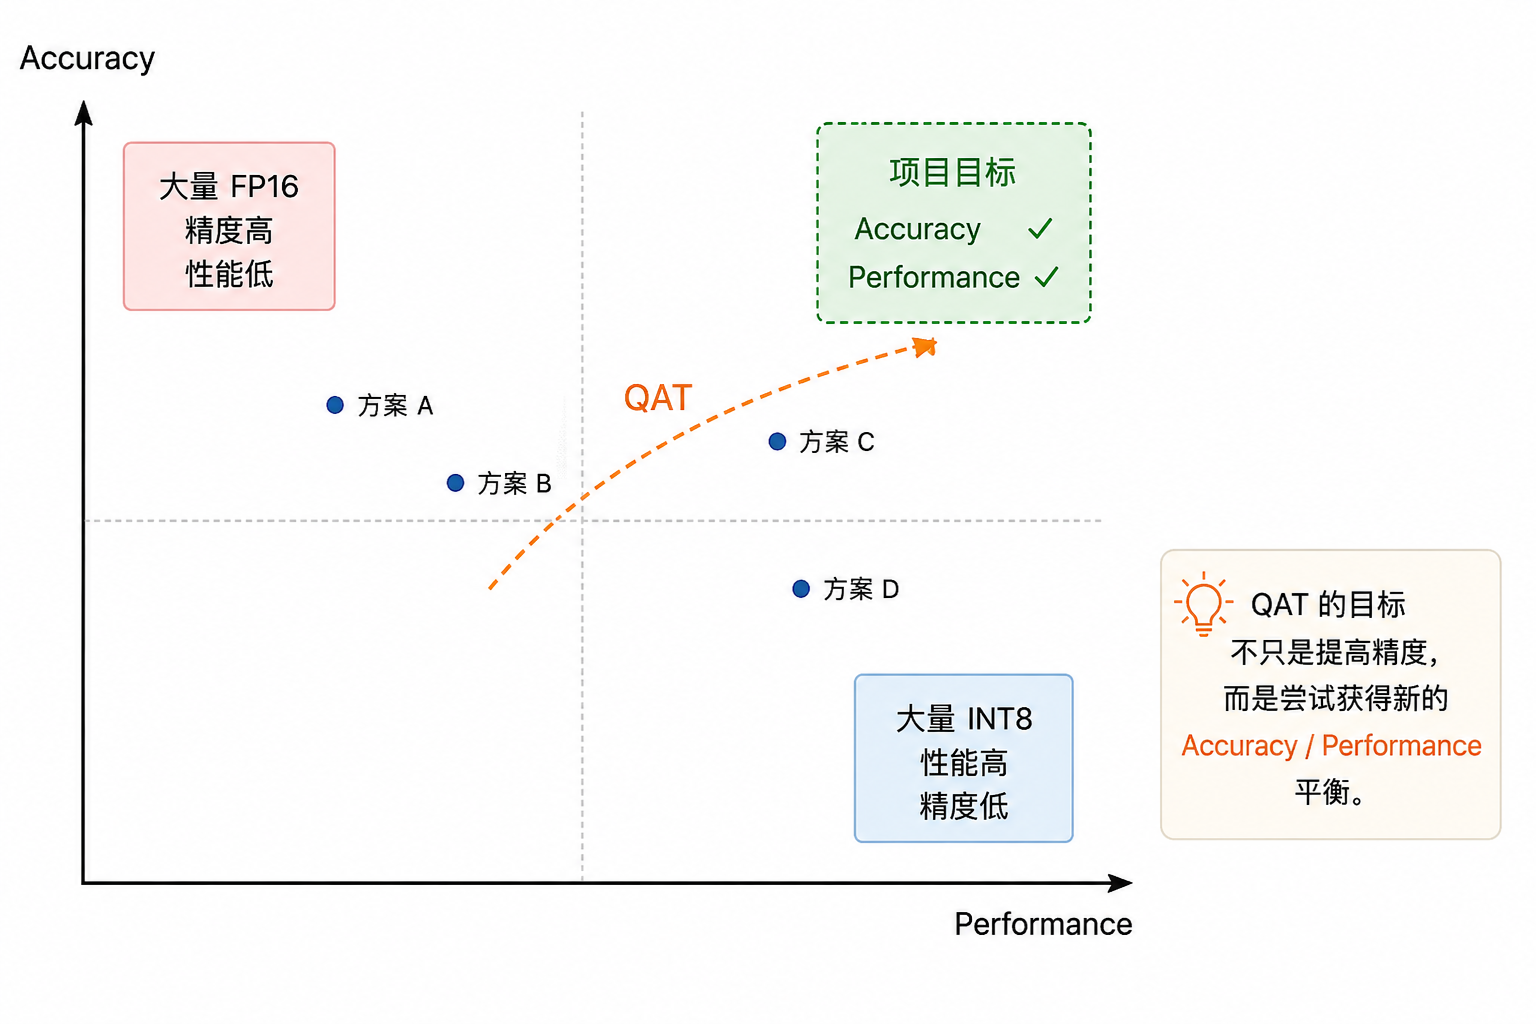
一个模型经过 PTQ 后精度满足业务要求,但为了保证精度,大量计算节点都需要使用 FP16。
最后虽然:
但是:
那么这仍然不能算一个合适的量化方案。
同样,如果模型几乎全部采用 INT8:
但是模型精度已经无法满足业务要求:
这个方案同样没有部署价值。
因此,无论选择 PTQ 还是 QAT,最终都应该围绕:
Accuracy + Performance
两个目标进行评价。
从工程角度来看,两者可以做如下对比:
对比项 | PTQ | QAT |
|---|---|---|
是否需要重新训练 | 否 | 是 |
是否依赖完整训练工程 | 较低 | 较高 |
数据需求 | Calibration 数据 | Calibration 数据、训练数据、验证数据 |
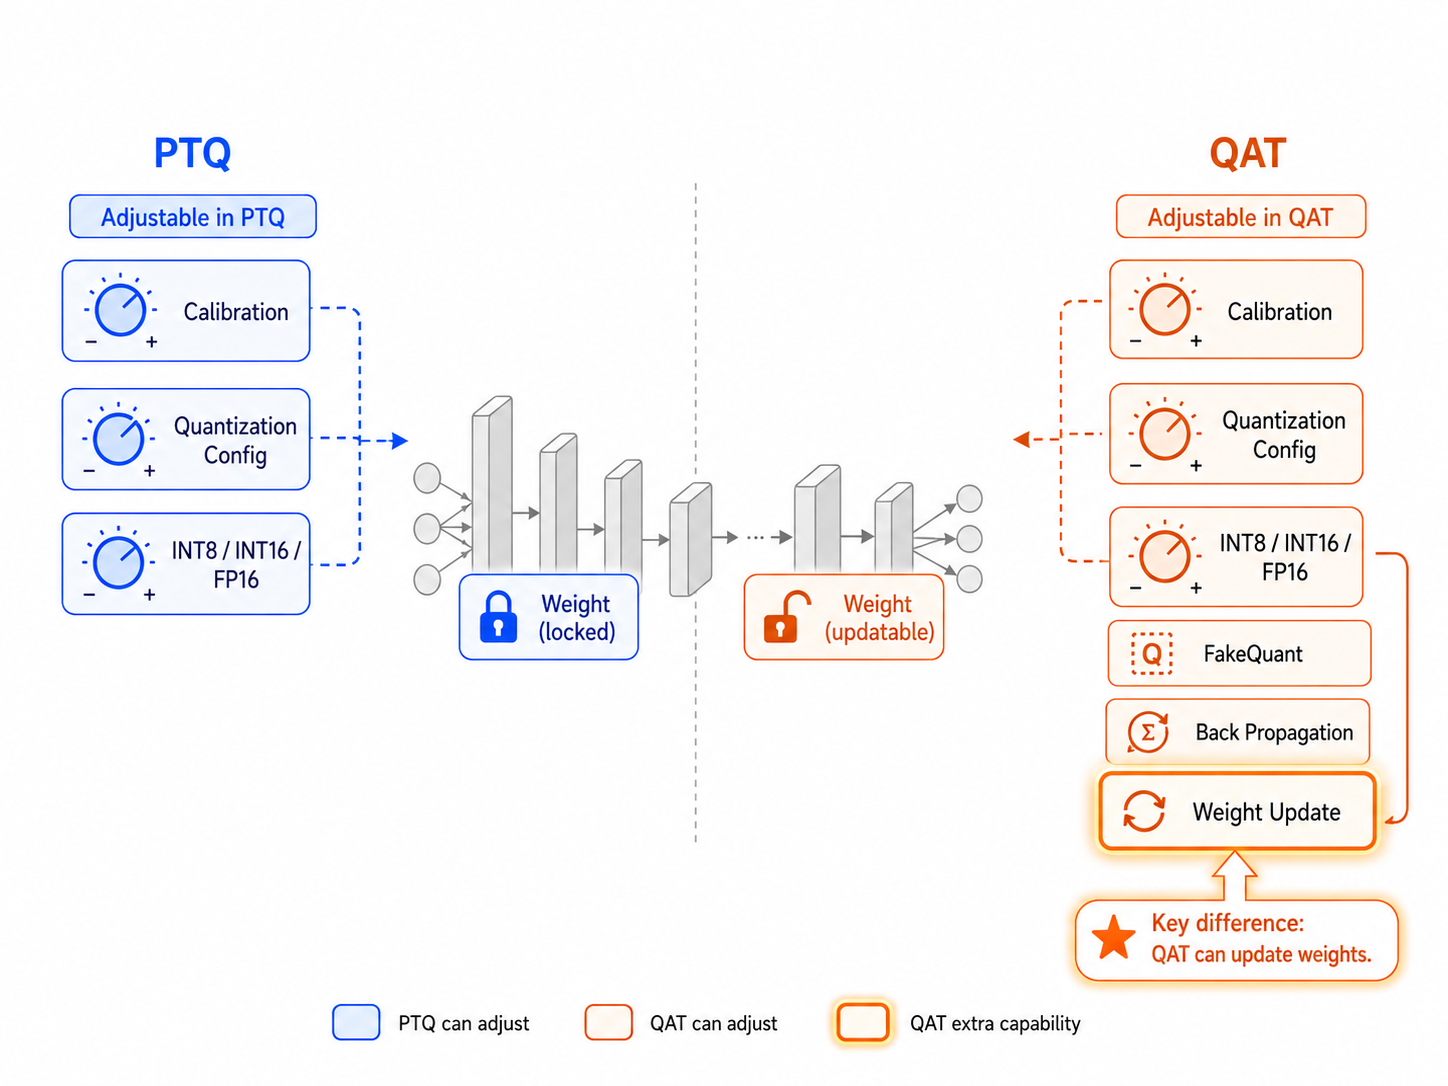
Weight 是否重新优化 | 否 | 是 |
实施成本 | 较低 | 较高 |
开发周期 | 较短 | 较长 |
精度调整方式 | Calibration、量化配置、混合精度等 | FakeQuant、QConfig、训练优化等 |
对量化误差的适应 | 调整量化方案 | 模型主动适应 |
典型使用方式 | 优先用于模型部署 | PTQ 难以兼顾精度与性能时进一步使用 |
可以看到,QAT 相比 PTQ 最大的区别并不是“量化得更精细”,而是:
模型 Weight 也可以参与到量化优化过程中。
可以把两者理解成:
PTQ
QAT
这也是为什么实际项目中通常更加推荐:
优先尝试 PTQ,而不是所有模型一开始就做 QAT。
三、PTQ 适用场景
对于 J6 模型部署,一个比较实用的原则是:
如果没有明确理由必须使用 QAT,优先从 PTQ 开始。
并不是因为 PTQ 一定比 QAT 更好,而是 PTQ 的工程成本通常明显更低。
3.1 常规、量化友好的模型
对于一些比较典型的 CNN 模型,例如:
图像分类模型
目标检测模型
语义分割模型
常规 Backbone
结构比较规则的卷积网络
如果模型的:
Weight 分布比较正常
Activation 数值范围比较稳定
没有大量明显的 Outlier
网络结构本身比较量化友好
那么 PTQ 通常已经可以获得比较不错的结果。
对于这类模型,没有必要为了追求理论上更高的量化精度而直接进入 QAT。
3.2 缺少完整训练工程
实际客户项目中经常遇到一种情况:
拿到的只有:
但是没有:
如果这时直接进行 QAT,就意味着必须重新获取甚至重新搭建完整的训练链路。
工程成本会非常高。
而 PTQ 对原始训练工程的依赖很低。
因此非常适合:
客户模型快速评估
模型可部署性验证
POC
第三方模型部署
只有 ONNX 模型的场景
3.3 PTQ 已经同时满足精度和性能
这是最简单的一种情况。
比如原始浮点模型:
业务要求:
PTQ 后:
此时:
那么 PTQ 就已经是一个合理的量化方案。
即使 QAT 理论上可能把 Accuracy 从 89.8% 提升到 89.9%,也不意味着值得为了这 0.1% 重新建立完整训练流程。
模型部署最终是工程问题。
应该关注的是:
是否满足业务需求。
而不是:
是否使用了最复杂的量化技术。
3.4 少量敏感节点使用高精度即可满足要求
PTQ 调优过程中,还有一种非常常见的情况。
例如:
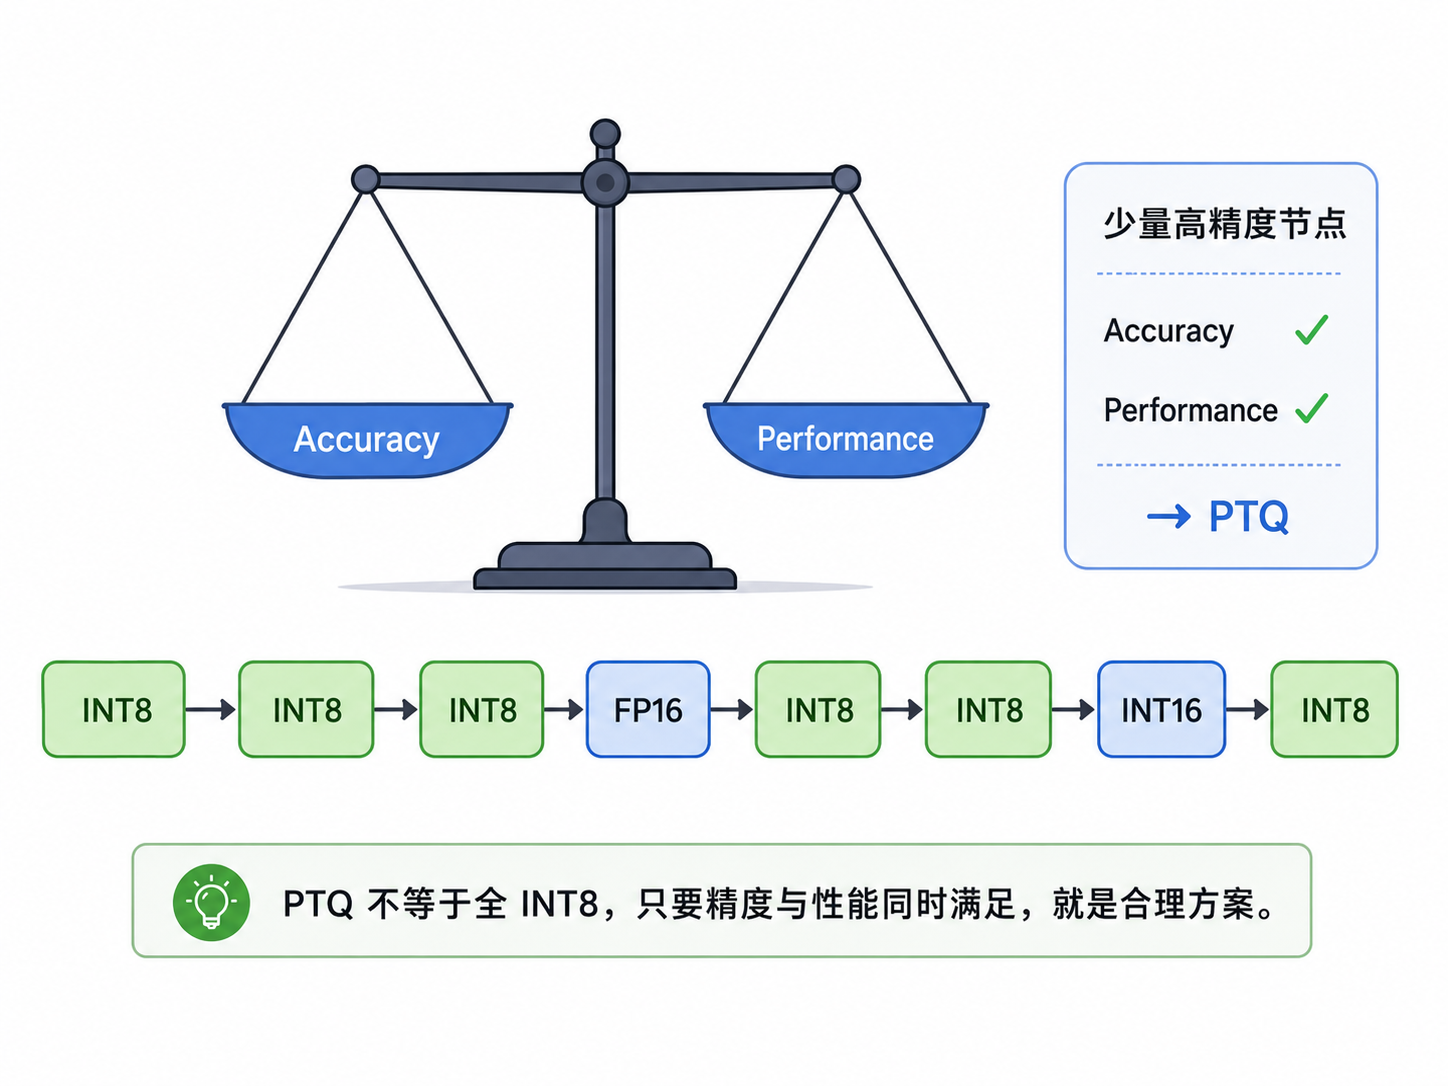
模型绝大多数节点使用 INT8 都没有明显问题,但只有少量节点对 INT8 比较敏感。
那么可以针对这些节点使用:
INT16
FP16
最终形成:
如果最终:
那么依然非常适合使用 PTQ。
这里需要建立一个比较重要的认识:
PTQ 的目标并不是追求“全模型 INT8”。
真正应该追求的是:
模型精度与实际执行性能之间的合理平衡。
例如:
而:
显然方案 B 才是更加合理的部署方案。
因此:
只要少量高精度节点不会明显影响整体性能,就没有必要因为模型不是全 INT8 而进入 QAT。
四、QAT 适用场景
QAT 是否有必要,并不能简单通过:
“PTQ 后掉精度了”
来判断。
因为很多 PTQ 精度问题,本身仍然可以通过:
Calibration 数据优化
Calibration 方法调整
敏感节点分析
INT8 / INT16 / FP16 混合精度
等方式解决。
真正需要考虑的是:
当前问题是否已经需要模型 Weight 本身参与量化优化。
其中有两种情况尤其值得关注。
4.1 Activation 使用高精度后,精度仍然无法满足
模型的量化误差可以简单拆分为:
也就是说,一个模型进行低比特量化后精度下降,既可能来自:
Activation 量化
也可能来自:
Weight 量化
甚至可能两者同时存在。
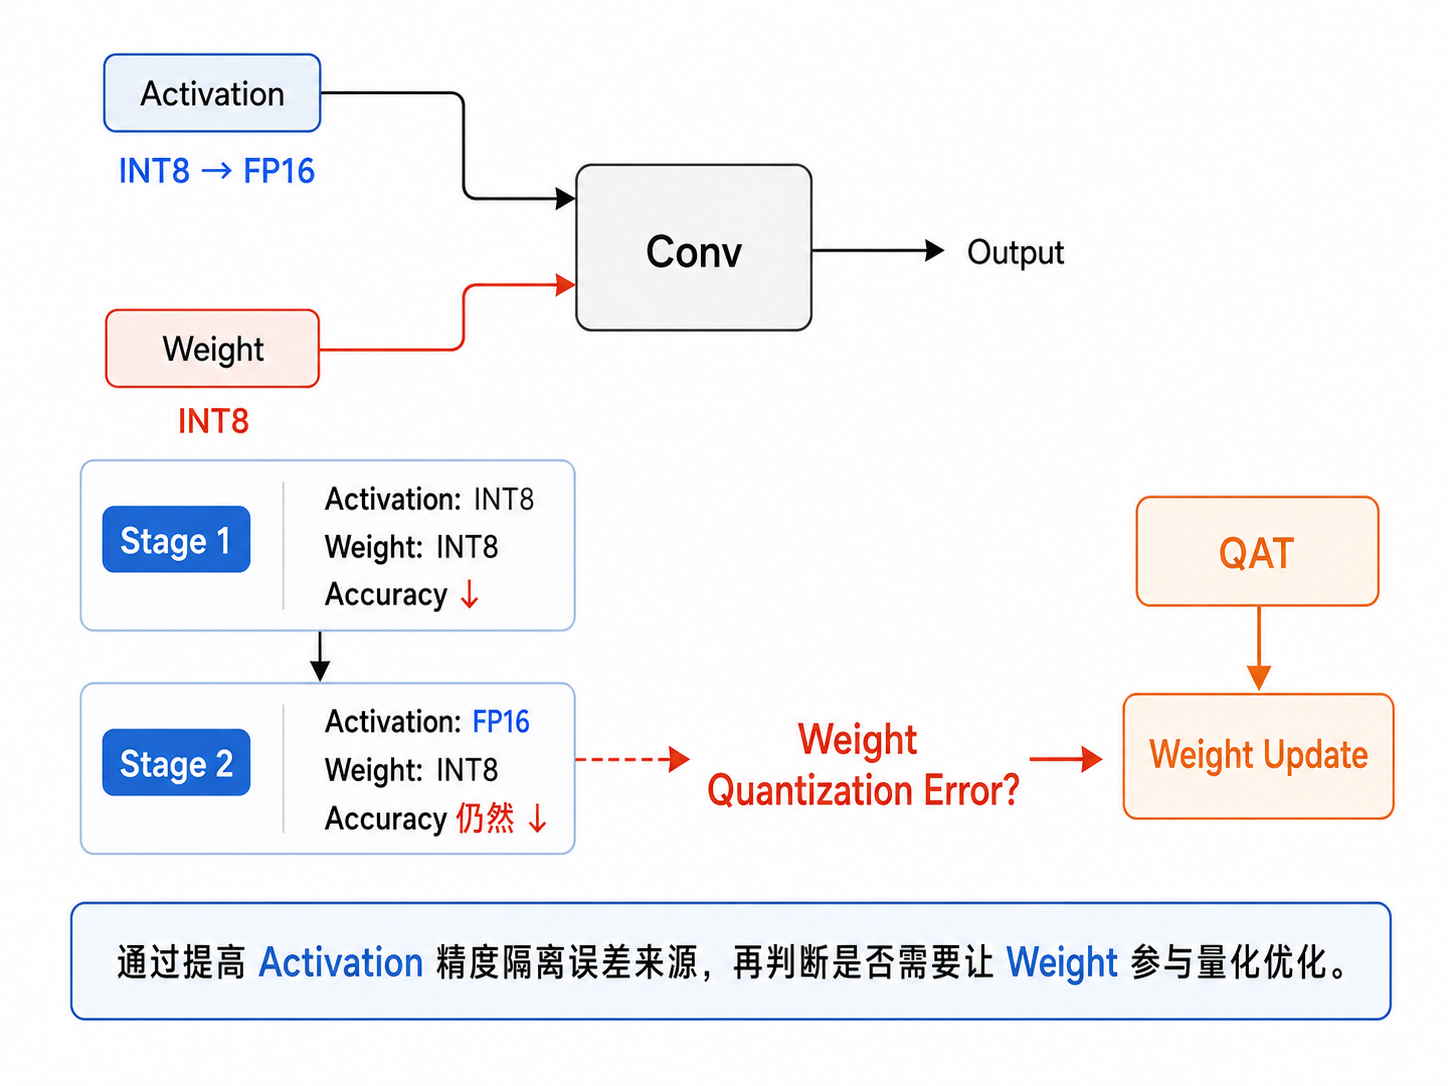
在 PTQ 调优过程中,如果发现某个节点 Activation 使用 INT8 后误差明显,可以首先尝试提高该节点 Activation 的精度。
例如:
如果提高 Activation 精度以后:
说明当前精度问题主要来自:
Activation Quantization Error
这种情况下仍然非常适合通过 PTQ 的混合精度继续处理。
进一步还可以做一个非常重要的验证。
在保证 Weight 仍然按照目标方案量化的情况下:
尽可能将 Activation 输出设置为 FP16。
这个实验的目的并不是最终真的把整个模型都做成 FP16。
而是为了帮助定位:
当前量化精度损失主要是不是来自 Activation。
假设:
然后:
那么就说明:
Activation 量化很可能已经不是当前最主要的问题。
这时候就需要进一步关注:
Weight Quantization Error
而 PTQ 在这里存在一个天然限制:
虽然可以调整:
但是:
原模型 Weight 本身不会主动发生改变。
而 QAT 可以做到:
模型在训练过程中,可以逐渐找到一组:
更加适合低比特表示的 Weight。
因此:
如果已经排除了 Activation 量化的主要影响,而 Weight 量化仍然导致明显精度下降,就更加适合考虑 QAT。
这里需要特别强调:
不能简单地说:
“把整个模型都设成 FP16,如果精度还不好,就说明 Weight 有问题。”
如果测试时 Weight 和 Activation 都切换成了高精度,那么这个实验已经无法起到隔离 Weight Quantization Error 的作用。
更准确的测试思路应该是:
尽量去除 Activation 量化影响,同时保留 Weight 量化,再观察模型精度变化。
4.2 PTQ 精度满足,但性能无法满足
还有一种情况并不是:
“PTQ 精度不够。”
而恰恰相反:
PTQ 的精度已经可以满足要求。
但是为了获得这个精度,模型不得不使用大量高精度计算。
比如最开始:
结果:
为了恢复精度,开始不断将量化敏感节点改为:
最终:
于是就会出现一种很典型的情况:
也就是说:
通过 PTQ 可以分别找到高精度方案和高性能方案,但是很难找到能够同时满足业务需求的组合。
这种情况尤其容易发生在:
某些量化敏感节点本身计算量非常大的模型中。
例如一个 Conv Block 或者 MatMul Block:
如果这个 Block 为了保持精度必须使用 FP16,那么即使其它小节点全部改成 INT8,整体性能也可能依然受到明显影响。
这时候,QAT 的价值就不仅仅是:
提高 Accuracy。
而是尝试做到:
通过 QAT:
最终希望实现:
因此:
如果 PTQ 可以满足精度,但必须依赖大量高精度计算,从而导致 J6 上的推理性能无法满足要求,那么 QAT 同样值得考虑。
QAT 在这种场景中的意义,是尝试让原本必须 FP16 才能保持精度的节点重新适应 INT8。
4.3 固定节点长期表现出明显量化敏感性
还有一种现象也值得注意。
在 PTQ 调优过程中,如果反复发现:
总是固定的一批 Layer 或 Block 对 INT8 非常敏感。
即使已经尝试:
更换 Calibration 数据
增加 Calibration 数据
调整 Calibration 方法
修改前后节点精度
调整量化参数
最终仍然集中在同一批节点出现明显误差。
那么问题可能已经不仅仅是:
Calibration 统计不准确。
而可能是:
这些节点对应的 Weight 或计算特征本身对低比特表示比较敏感。
这种情况下,也可以进一步评估 QAT。
4.4 Calibration 已经稳定但精度仍有明显差距
Calibration 数据对于 PTQ 非常重要。
但是实际调试中,也容易陷入一个误区:
“精度不好,是不是 Calibration 数据还不够多?”
Calibration 数据不是越多越好。
更重要的是:
是否能够代表真实业务数据分布。
比如:
如果随着 Calibration 数据不断增加,量化结果已经基本稳定:
但是距离业务目标:
依然有明显差距。
那么继续单纯增加 Calibration 数据通常已经很难解决这个问题。
这时候应该进一步分析:
Weight Quantization Error
Activation Quantization Error
模型中的异常数值范围
固定量化敏感节点
模型结构是否量化友好
如果最终发现问题主要集中在 Weight 对低比特计算的适应性上,那么就更加适合考虑 QAT。
需要注意的是:
QAT 并不是所有 PTQ 问题的兜底方案。
在进入 QAT 之前,仍然应该确认:
Calibration 数据是否具有代表性
浮点模型本身是否正确
前处理是否一致
后处理是否一致
是否存在异常大的数值范围
是否存在明显不合理的网络结构
是否存在算子实现差异
因为:
QAT 可以改善模型对量化的适应能力,但不能替代基础问题排查。
五、PTQ 还是 QAT
回到最开始的问题:
J6 模型部署到底应该选择 PTQ 还是 QAT?
其实可以把前面的判断浓缩成下面这张表。
模型量化情况 | 推荐路线 |
|---|---|
PTQ 后精度满足,性能满足 | PTQ |
少量节点使用 INT16 / FP16 后,精度和性能均满足 | PTQ |
提高 Activation 精度后可以恢复模型精度,并且性能满足 | PTQ |
排除 Activation 量化主要影响后,Weight 量化仍导致明显精度下降 | 考虑 QAT |
PTQ 能够满足精度,但需要大量高精度节点,导致性能无法满足 | 考虑 QAT |
固定的一批 Layer 长期对 INT8 表现出明显敏感性 | 评估 QAT |
Calibration 已具有代表性且结果稳定,但仍存在明显量化误差 | 进一步分析后评估 QAT |
整个选择过程可以进一步简化成:
所以,在 J6 上,PTQ 和 QAT 并不是两个互相独立、必须一开始就二选一的方案。
更符合实际工程的流程往往是:
如果能够通过 PTQ,以比较低的工程成本同时满足:
那么就没有必要额外增加 QAT 所带来的训练和调试成本。
而如果已经明确:
Activation 使用高精度后,Weight 量化仍然带来明显精度损失;
PTQ 为了保证精度不得不引入大量 FP16 / INT16,导致性能无法满足;
固定的一批高计算量节点长期表现出明显量化敏感性;
那么 QAT 就可能是更加合适的路线。
最终判断 PTQ 还是 QAT,可以始终围绕两个最简单的问题:
精度满足了吗?
性能满足了吗?
只有这两个目标同时满足,才是最终适合部署到 J6 上的量化方案。
