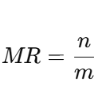1. 什么是 Prefix Caching
在实际业务中,不同请求之间往往存在大量相同的 Prompt 前缀,例如:
相同的 System Prompt
相同的角色设定
相同的工具定义
多轮对话中已经产生的历史上下文
简而言之,Prefix 是请求 Token 序列中位于前面的、可以被后续请求共享的部分。如果每次请求都重新计算这些相同内容,就会产生大量重复计算。
可以简单理解成:
2. KV Cache 基础简介
要理解 Prefix Caching,必须先理解 KV Cache。
Transformer 的 Self-Attention 可以简单表示为:
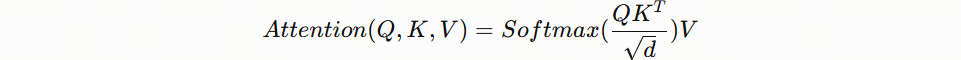
对于已经处理过的 Token,其 Key 和 Value 在后续计算中还会被继续使用。因此,LLM 推理过程中不会每次都重新计算历史 Token 的 K/V,而是将它们保存下来:
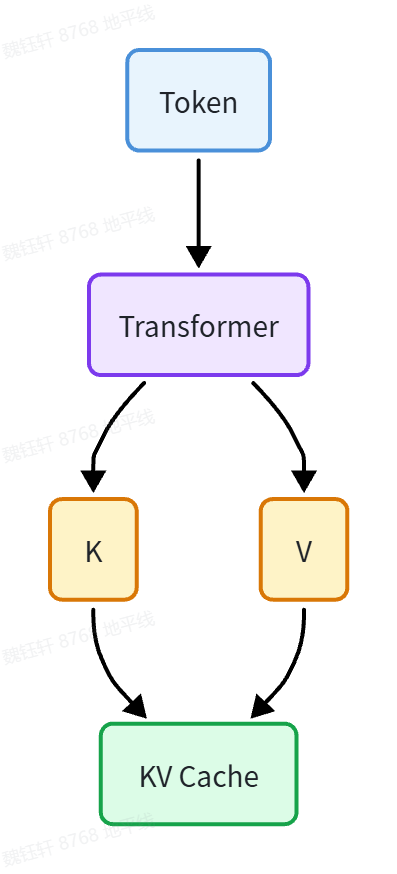
例如:
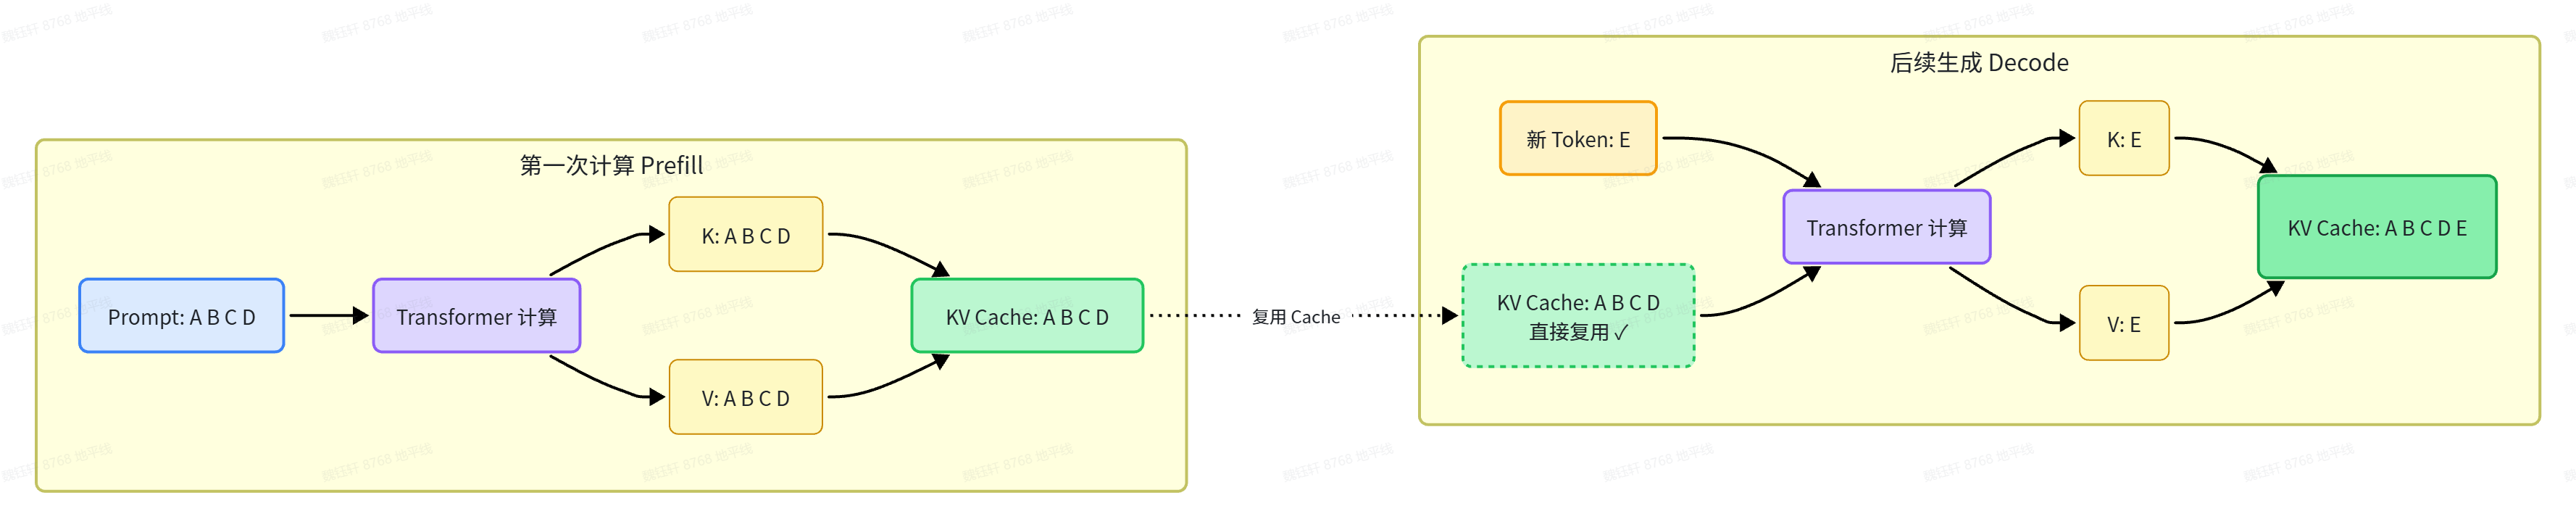
3. 普通 KV Cache 和 Prefix Caching 的区别
两者非常容易混淆。
普通 KV Cache
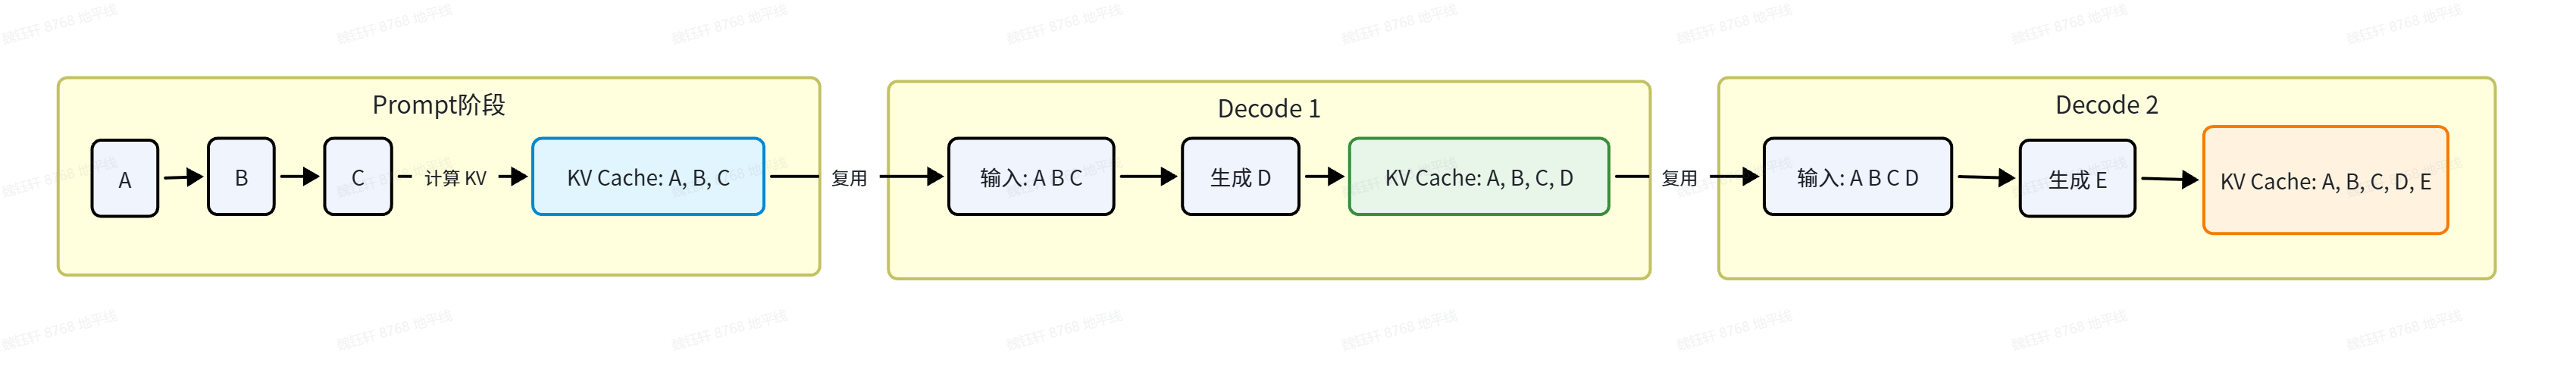
Prefix Caching
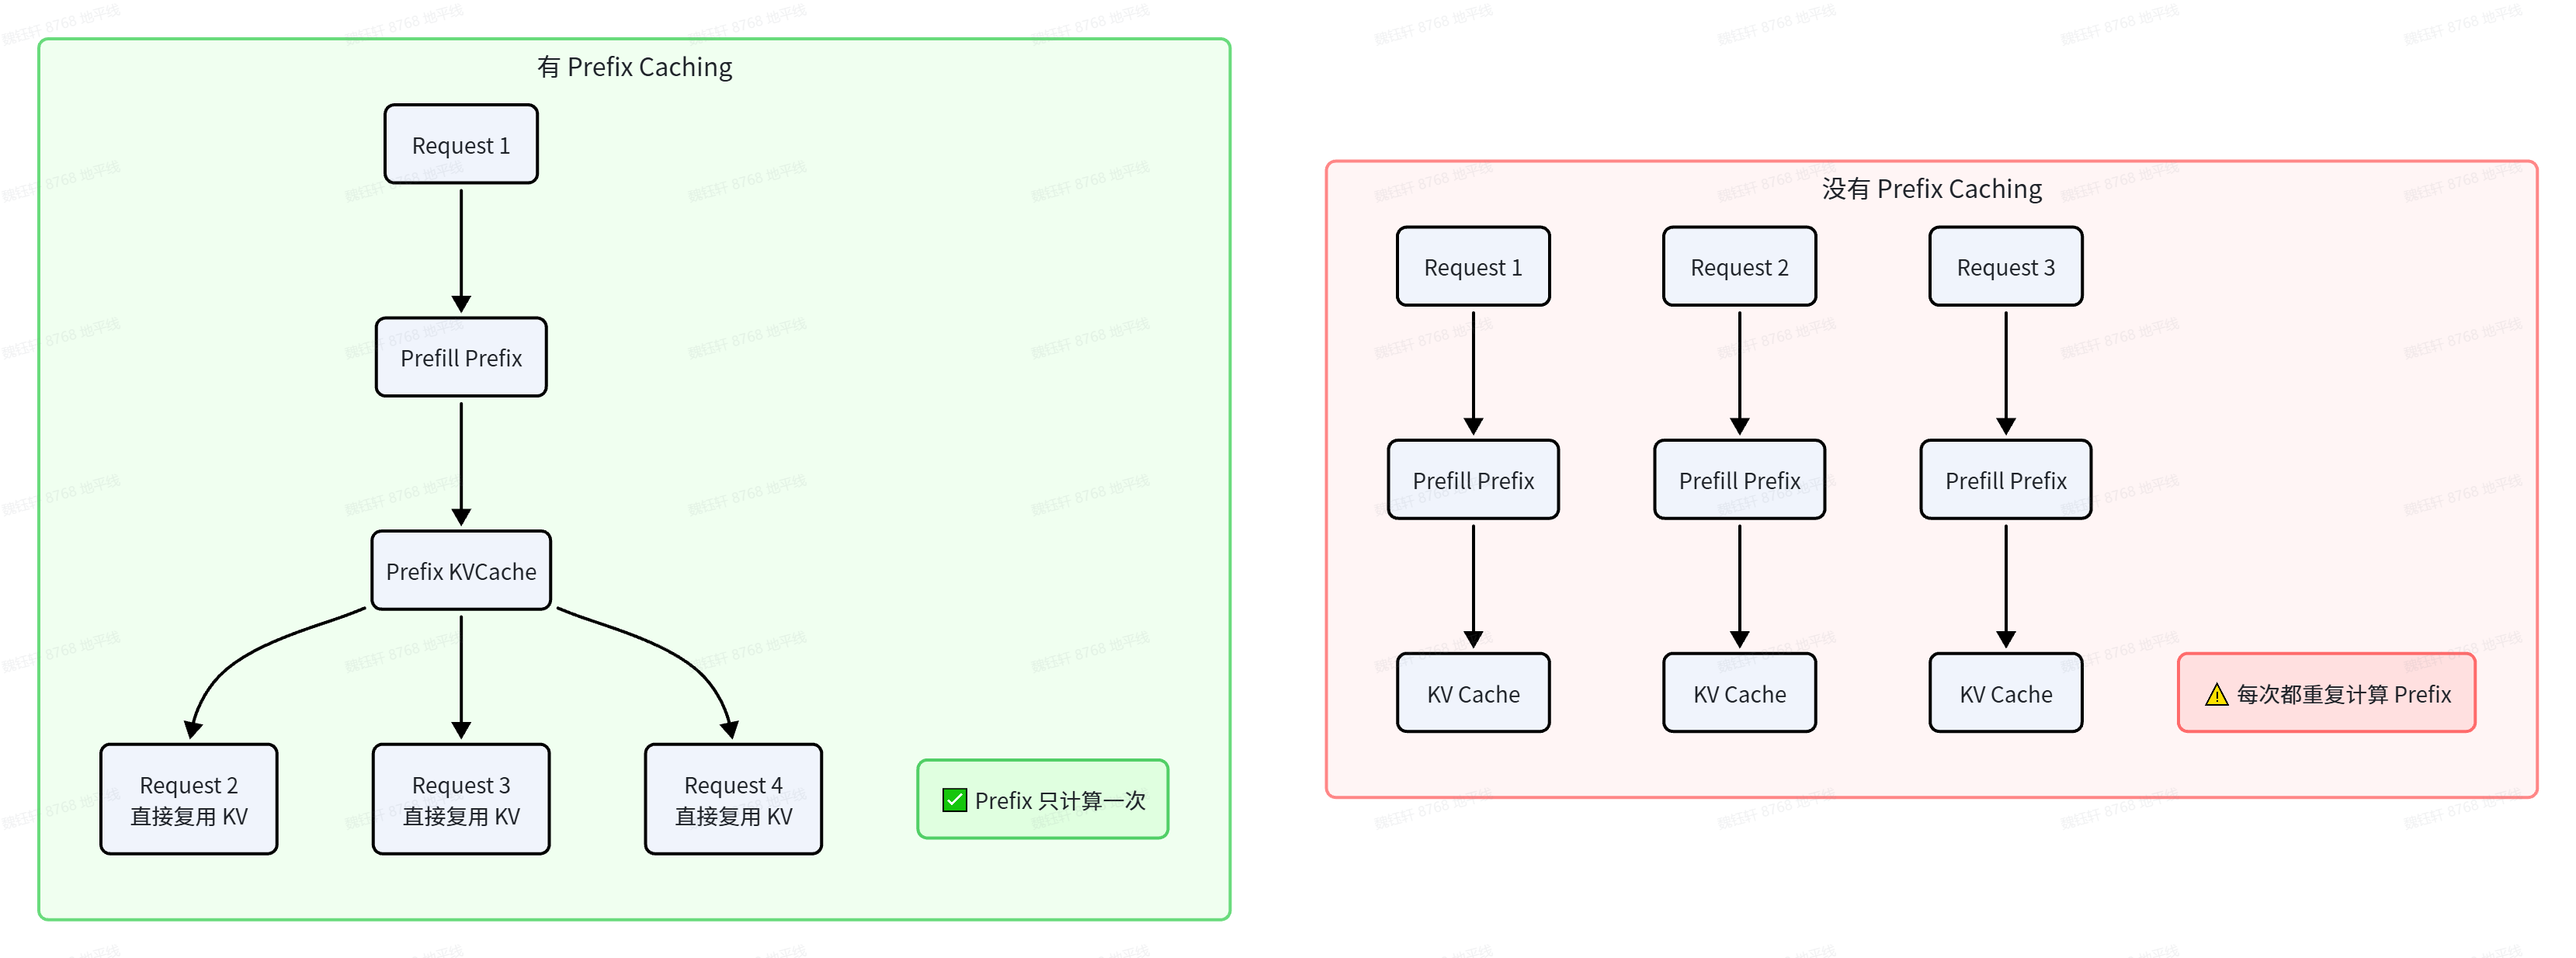
例如:
三个请求虽然 User Prompt 不同,但是:System Prompt完全相同,因此:System Prompt可以复用。
4. Prefix Caching 是怎么工作的
例如:
接下来看Cache Hit,假设已有请求:
新请求:
系统按 Block 顺序匹配:
最终,新请求可以直接复用前两个 Block:
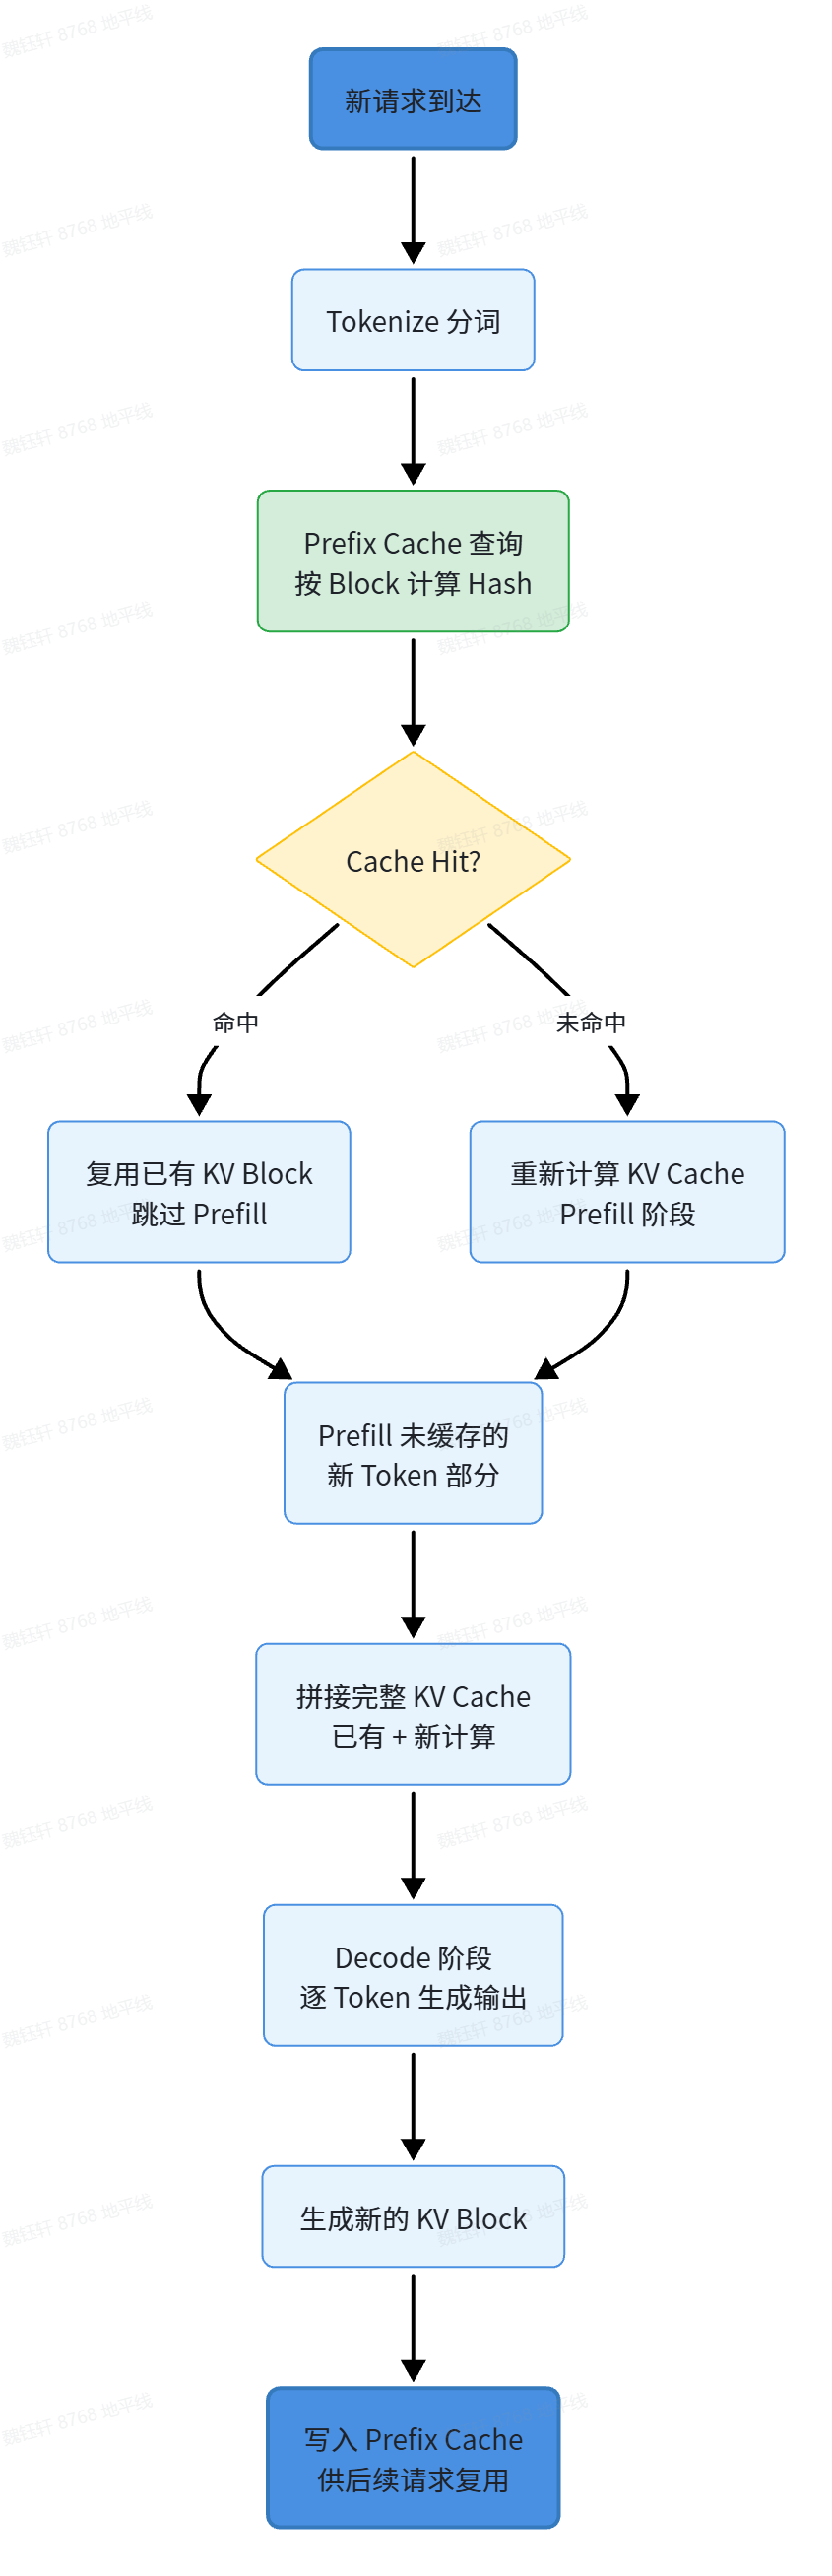
核心原理:通过“Prefix + 当前 Block”生成 Hash,快速定位可复用的 KV Block;命中的 Block 直接复用,仅从第一个未命中的 Block 开始重新 Prefill。
注:实际实现通常只缓存完整 Block,不完整的尾部 Block 一般不能作为独立的可复用缓存单元。
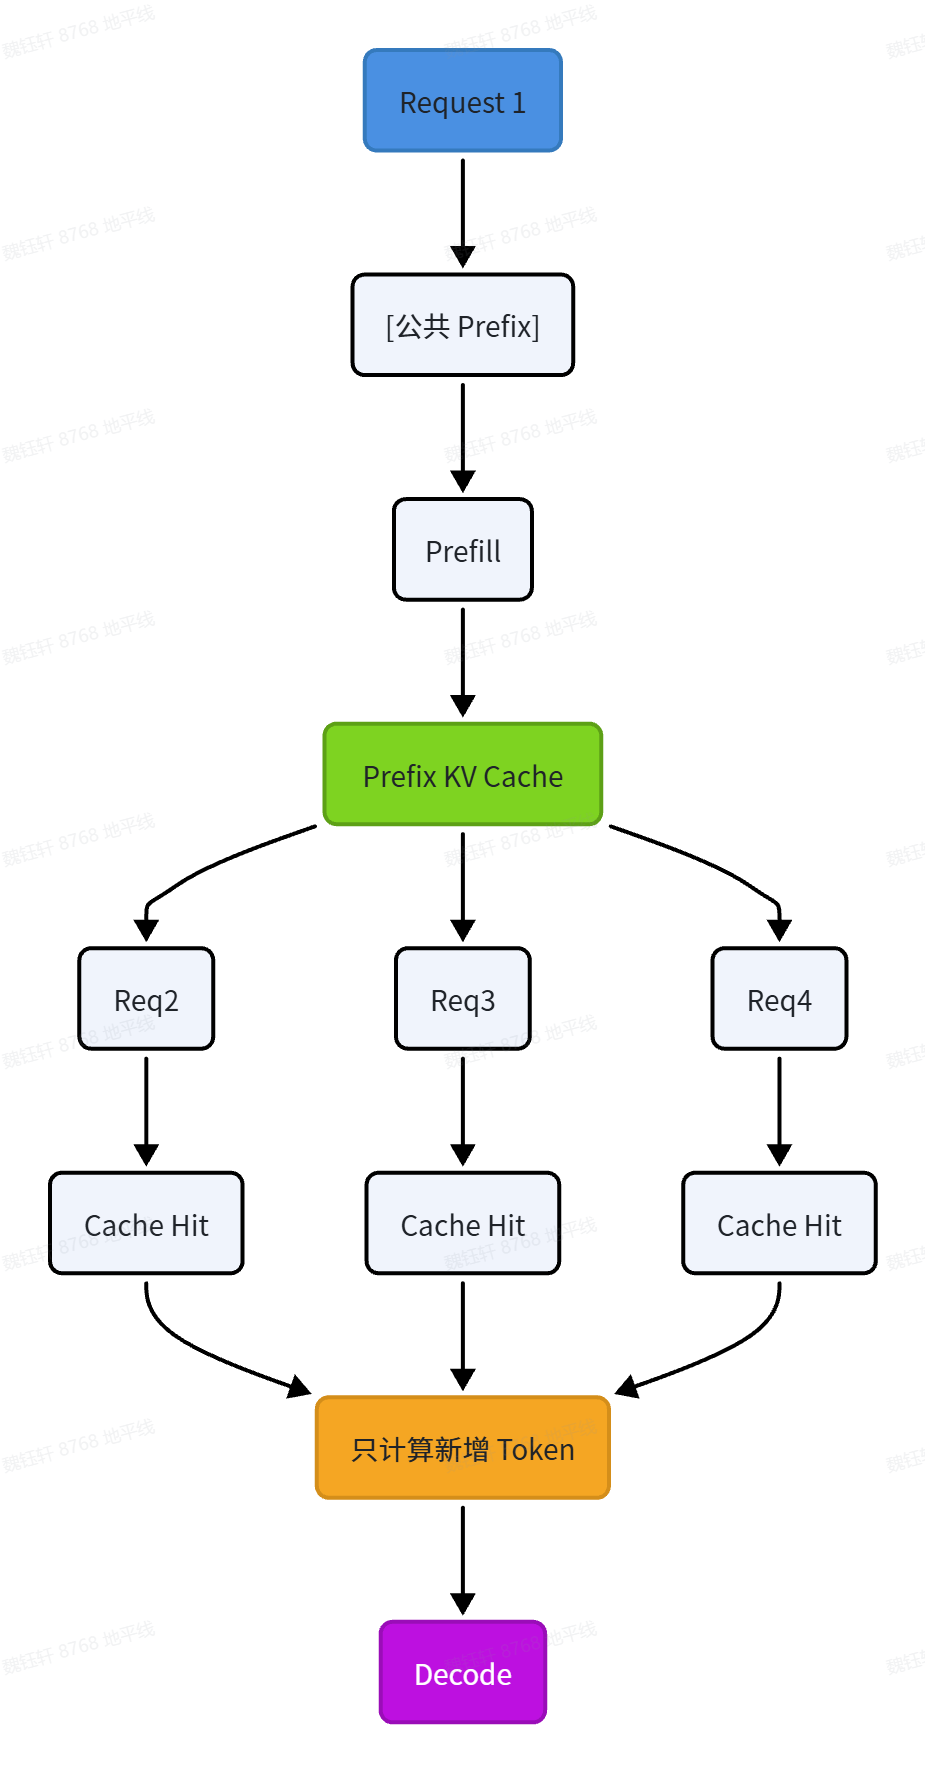
总体看来,prefix caching整个流程概括为:
5. 为什么只需要匹配 Prefix
因为 Transformer 的 Causal Attention 具有一个重要特性:
因此,如果:
6. Prefix Caching 对性能的影响
Prefix Caching 会复用公共前缀已经计算好的 KV Cache。缓存命中后,只需对新增 Token 执行 Prefill,从而减少重复计算。Prefix Caching缩短的是 Prefill 阶段,因此主要降低 TTFT(首 Token 延迟);Decode 阶段仍需逐 Token 生成,TPOT 基本不受影响。公共前缀越长、输出越短,收益越明显;输入短而输出长时,收益有限。
例如,4000 Token 的 System Prompt 加 20 Token 的 User Prompt:首次请求处理 4020 Token;后续命中缓存时主要处理新增的 20 Token。实际收益 还受缓存查找、内存访问和 Block 管理开销影响。
7. Prefix Caching应用场景
Prefix Caching 适合长且稳定的公共前缀被反复使用的请求,典型场景包括:
- 长 System Prompt:Agent 身份、工具定义、行为规则和业务知识在多个请求中保持不变。
- 多轮对话或重复查询长文档:历史上下文或文档前缀相同,每轮只增加少量内容。
- 自动驾驶与智能座舱 Agent:能力说明、工具定义和安全规则通常较长且固定,而用户指令短且高频,可缓存公共 Prompt 以降低 TTFT 和 Prefill 压力。
公共前缀越长、复用次数越多、后续新增内容越少,收益越明显;前缀频繁变化或缓存命中率低时,收益有限。
8. Prefix Caching与常见概念的区别
8.1 与 Paged KV Cache 的关系
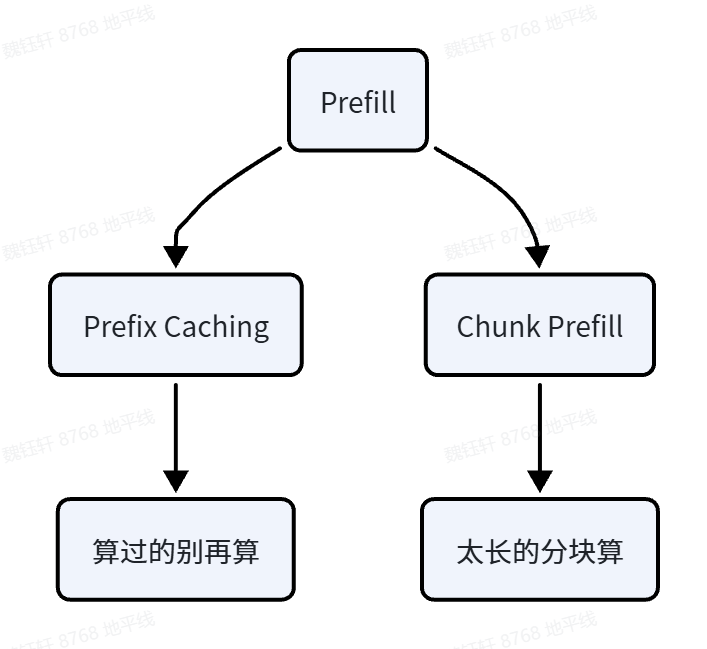
8.2 与 Chunk Prefill 的区别
这两个技术都属于 Prefill 优化,但解决的问题完全不同。可以这样理解:
9. Prefix Caching 的局限性
主要限制包括:
- 缺少公共 Prefix:Cache Hit 低,复用收益有限。
- Prefix 较短:命中后节省的计算量有限。
- Decode 占比高:Prefix Caching 主要优化 Prefill,长 Decode 场景整体收益有限。
- Cache 容量有限:KV Cache 占用显存,需要通过 Cache Management 和 Eviction 淘汰低价值 Block。
10. 一句话理解 Prefix Caching
整个过程可以浓缩成: