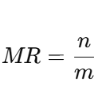声明:本文主要参考公开资料整理撰写,如有错漏,欢迎评论交流~
1. 传统decode慢在哪里
大模型生成文本是一个字一个字往外蹦的。要写 100 个 token,就得跑 100 次模型——这叫自回归,绕不开,因为下一个字是什么,取决于前面已经写出来的字。
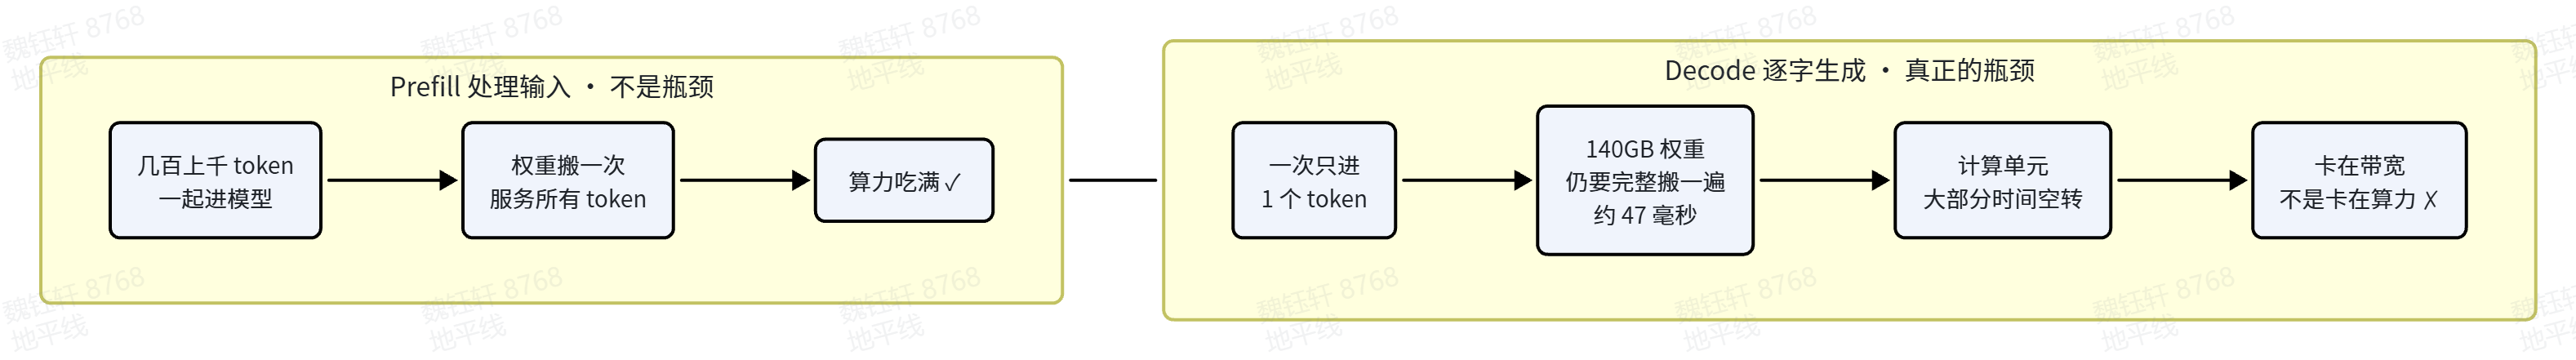
问题在于每跑一次的代价。以一个 70B 的模型为例,权重按 FP16 存要 140GB,每生成一个 token,这 140GB 就得从显存完整读一遍,外加不断增长的 KV cache。而这一次前向真正做的计算量,仅相当于处理一个 token。
算力和访存严重失衡。H100 的算力是每秒数百 TFLOPS,但显存带宽只有 3TB/s 左右。搬 140GB 权重要 47 毫秒,这期间 GPU 的计算单元基本在空转。所以 decode 阶段慢,不是因为算不过来,而是数据喂不进去——业内把这种情况叫 memory bandwidth bound。
顺带说一句,处理输入 prompt 的 prefill 阶段没这个毛病。那一步几百上千个 token 一起进模型,权重搬一次就服务了所有 token,算力能吃满。真正的瓶颈只在逐字生成的 decode 阶段。
2. 投机采样定义
既然搬一次权重只产出一个 token 太亏,能不能让它一次多产出几个?
直接让模型一次吐 4 个字是不行的,那违背了自回归的因果关系。但换个角度:如果有人能先猜出接下来的 4 个字,我们让大模型一次性检查这 4 个猜测对不对,情况就不同了——大模型的权重仍然只搬一次,却可能一口气确认好几个 token。
这就是投机采样。找一个又小又快的模型先猜,大模型负责验收。
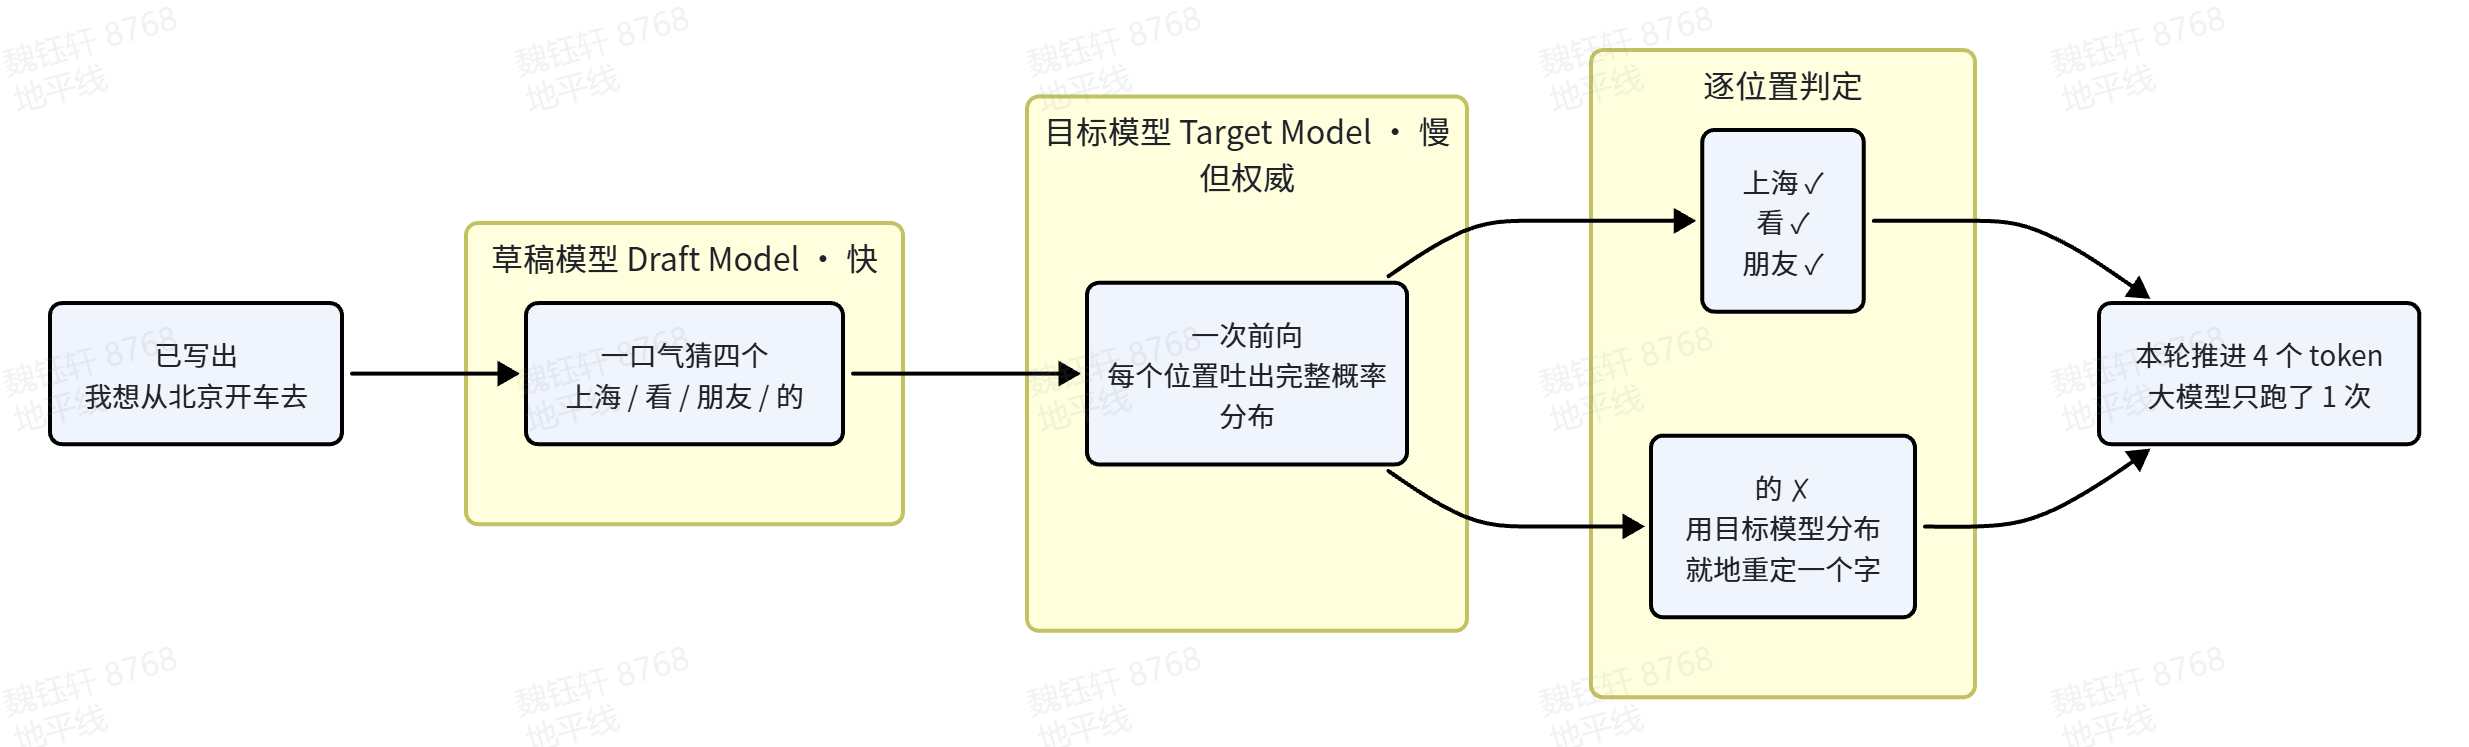
猜的那个通常叫草稿模型(Draft Model),可以是同系列的小尺寸版本。验收的叫目标模型(Target Model),最终输出以它为准。
举个例子。已经写出"我想从北京开车去",草稿模型飞快地补了四个词:"上海""看""朋友""的"。目标模型一次前向把这四个位置全查一遍,发现前三个它自己也会这么写,第四个不认可——那就接受前三个,第四个用目标模型自己的分布重新定一个字。这一轮下来推进了四个 token,而大模型只跑了一次。
3. 并行验证的支持原理
这一步是整个方法能成立的关键,也最容易想不通:既然生成是逐字的,凭什么验证可以并行?
因为验证和生成是两回事。生成第 4 个字时,你手上没有第 1、2、3 个字,必须依次算出来。但验证的时候,草稿模型已经把这四个字都给你了——它们作为一整个序列送进目标模型,跑一次前向就能拿到每个位置上的预测分布。
Transformer 的因果掩码保证了第 i 个位置只能看到它前面的内容,所以第 i 个位置输出的分布,恰好就是"给定前 i 个字之后,第 i+1 个字应该是什么"的真实答案。这正是验证第 i 个草稿字所需要的东西。四个位置的答案,在同一次前向里全都有了。
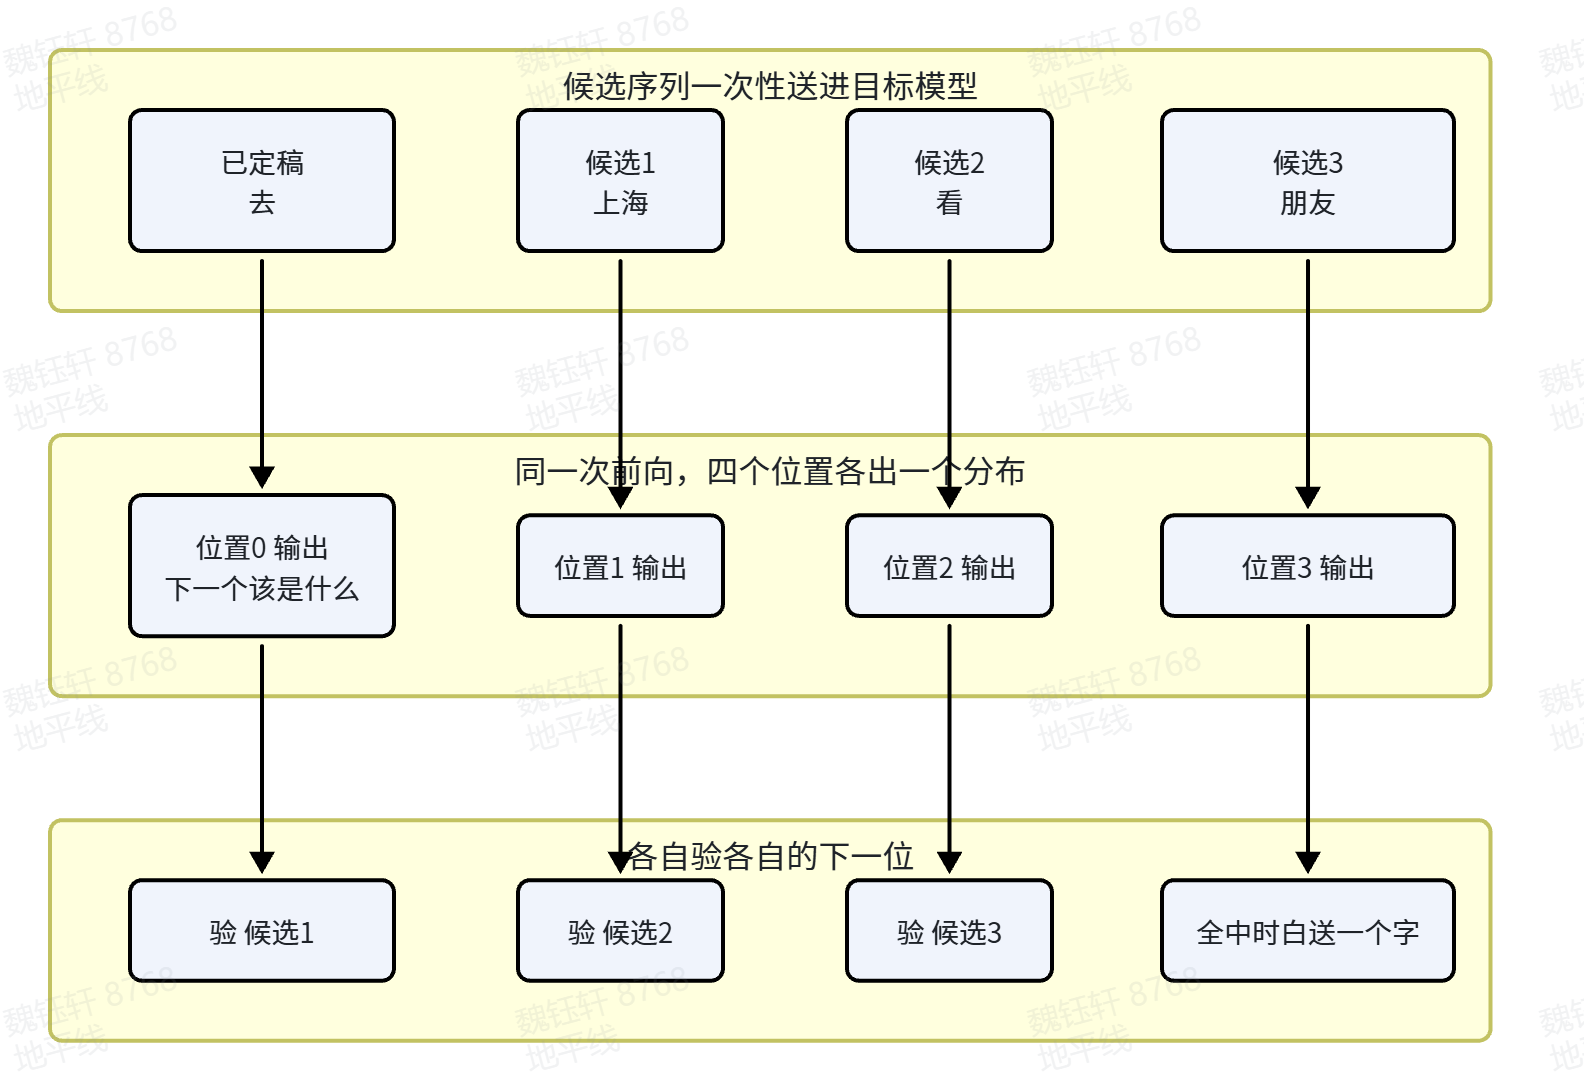
换句话说,训练时那种"一个序列并行算所有位置"的能力一直都在,只是常规解码用不上——因为没有候选序列可喂。草稿模型的作用,就是把这个序列造出来。
4. 验证规则之接受与拒绝
验证的规则比"对了就留、错了就扔"要讲究一些,因为随手一扔会让输出分布跑偏。
这两种情况下,验证草稿的方式完全不同。
这里有个容易忽略的细节:目标模型那一次前向,每个位置吐出的是完整的概率分布,判定接受只用到了其中一个数——草稿那个字的概率。分布里剩下的信息不会浪费,正好用来在拒绝时就地补一个字,不需要为此再跑一次模型。
所以一轮的产出在 1 到 k+1 之间:全中时最后一个位置的分布还能额外白送一个字,猜 4 个最多推进 5 个;第一个字就被拒,则只产出那一个修正字。
这里要澄清一个容易想歪的地方:既然被拒的位置也会由目标模型补上正确的字,那草稿模型是不是可以随便猜?不行。产出 1 个 token 这种情况下,目标模型跑了一次前向——和普通解码一模一样,但你额外付出了草稿模型那 4 步的计算。草稿的开销是净增的,猜得越差,这部分就越是纯亏。
准确的说法是:目标模型的前向次数不会比普通解码更多,但草稿本身的成本必须靠足够高的接受率赚回来。这也是为什么下一节的接受率是决定性指标——它不只关系到能快多少,还关系到会不会反而变慢。
5. 接受率
衡量效果的核心指标是接受率:草稿模型提出的字里,最终有多大比例被采纳。
这个数字直接决定加速比。假设目标模型跑一次 100 毫秒,草稿模型每步 10 毫秒。猜 4 个字要 40 毫秒,加上目标模型验证的 100 毫秒,一轮 140 毫秒。全接受的话推进 5 个 token,摊下来每个 28 毫秒,比原来的 100 毫秒快了三倍多。
但接受率低的时候账就翻过来了。假如平均只有第一个字能中,一轮 140 毫秒只推进 2 个 token(1 个接受 + 1 个修正),每个 70 毫秒,勉强还有得赚;要是第一个字就常被拒,一轮 140 毫秒只换来 1 个 token,比普通解码的 100 毫秒还慢了四成。多花的那 40 毫秒全喂给了白跑的草稿。
所以草稿模型卡在一个两难里:小了快但猜不准,大了准但本身就慢。理想的草稿模型要同时满足"足够快"和"预测分布贴近目标模型",这两个要求天然打架。
实践中还有两个容易忽略的点。
回到开头那笔账。batch 为 1 时,搬 140GB 权重要 47 毫秒,而这些权重只服务 1 个 token,矩阵乘的计算量微乎其微,算力大量闲置。此时验证 4 个草稿字,权重照样只搬一遍,访存一分不多,只是计算量涨了 5 倍——而这 5 倍正好落在原本空转的算力上,几乎不额外耗时。vLLM 的文档把这种情况称为草稿 token"近乎免费"。
并发升上去之后,情况整个反转。batch 为 256 时,同样 47 毫秒的权重搬运服务了 256 个 token,矩阵乘从"矩阵乘向量"变成"矩阵乘矩阵",计算量涨了两个数量级,GPU 逐渐从访存受限转为算力受限。这时算力不再是白送的了:草稿 token 要和真实请求抢同一份算力,每一个被拒的草稿都是实打实浪费掉的计算——那部分算力本可以用来服务另一个用户的真实 token。拒得多了,总吞吐会直接下降。
再叠加上目标不同:低并发的在线交互,用户盯着屏幕等字往外蹦,在意的是单个请求多快出字;高并发的离线批处理,在意的是单位时间总共处理多少 token。前者正是投机采样直接压缩的指标,后者恰恰是它可能拖累的指标。
任务类型同样有影响。写代码、生成 JSON 这类局部高度可预测的内容,小模型往往能猜得八九不离十;开放域的闲聊或创意写作,接受率通常低不少。
这两个因素叠在一起,意味着"猜几个字"的最优值会随负载漂移——并发低时该多猜,并发高时该少猜甚至干脆不猜,而接受率又随任务类型变化。所以没有哪个固定的草稿长度能适配所有并发档位。vLLM 为此做了动态验证(adaptive verification),按实时负载调整每轮猜几个字。
6. MTP:把草稿模型收进主模型
外挂一个草稿模型有现实的麻烦:得额外部署、额外占显存,还要费心保证它和目标模型的口味足够接近。
MTP(Multi-Token Prediction)换了个做法——不用外人,在主模型里直接长出几个轻量的预测头,专门负责往后多看几步。
这些头结构很轻。以 DeepSeek 为例,一个 MTP 头就是两个归一化层、一个线性投影、外加一层完整的 decoder。它的输入是主模型算出来的隐状态,和新 token 的 embedding 拼在一起,投影回原来的维度,再过那一层 decoder 出结果。词表和输出头都跟主模型共用,不额外占地方。
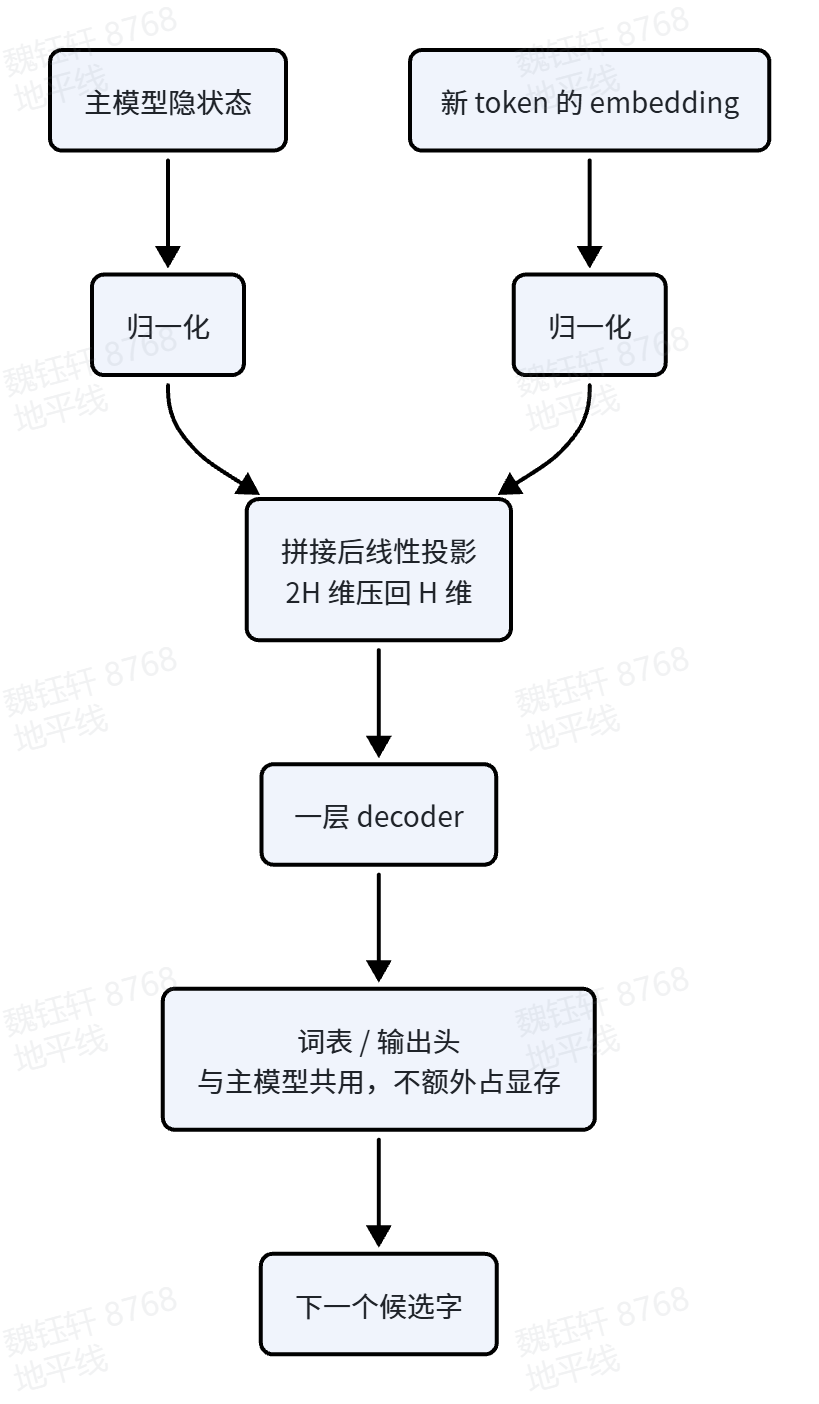
这么设计的好处很直接:它吃的是主模型的隐状态,等于站在主模型的肩膀上猜,预测分布天然贴近目标模型,接受率比外挂的小模型高不少。而且权重就在主模型的 checkpoint 里,部署时不用多管一个模型。
要一次猜多个字,就让这个头自己跑几步——第一步的产出喂回去当第二步的输入,如此往复。有的模型 checkpoint 里带了好几个头,可以一步用一个;只带一个的(比如 DeepSeek-V3)就同一个头反复用。
需要说清楚的是 MTP 和投机采样的关系,这两个概念经常被混为一谈。MTP 是一种"多预测几步"的模型能力,它只管猜;投机采样是"猜完再验"的推理策略,它管整个流程。MTP 产出的候选仍然要走完整的验证流程才能算数。所以准确的说法是:MTP 给投机采样提供了一个成本更低、质量更高的候选来源。
在 vLLM 这类推理引擎里,MTP 和 EAGLE(另一种同样基于主模型隐状态的方案)走的其实是同一套代码,差别只在头的具体结构和权重来自哪里。
7. 完整pipeline
把上面的环节串起来,一轮迭代是这样跑的:
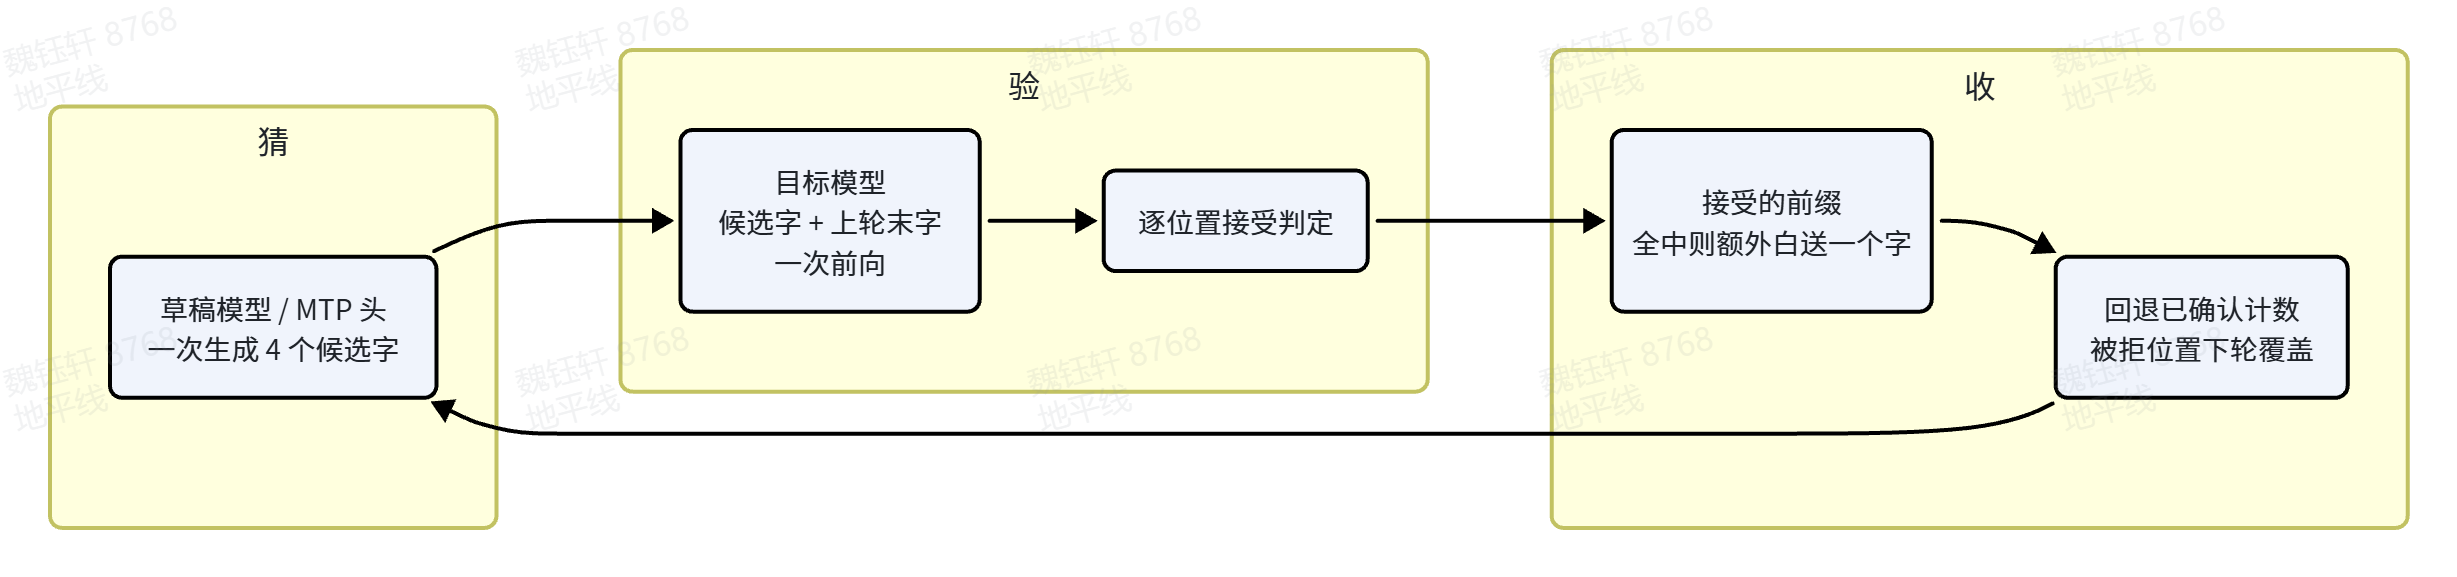
草稿模型(或 MTP 头)先猜出若干候选字,这些字连同上一轮确定的最后一个字,一起送进目标模型跑一次前向。拿到每个位置的预测分布后,逐位置做接受判定,得到一段被接受的前缀。全接受的话再加上白送的那个字。
被拒绝的字对应的 KV cache 不需要专门清理——推理引擎只把"已确认到第几个 token"这个计数往回退,那些位置在下一轮会被新内容原地覆盖。唯一要小心的是前缀缓存不能存进未定稿的内容。
接受的字追加到上下文里,草稿模型接着猜下一批,循环到生成结束。
8. 投机采样应用场景
投机采样是"质量无损"的加速手段,这点很有吸引力——不用在速度和效果之间做取舍。但无损只保证不变差,不保证一定变快。
它会不会真的变快,取决于两件事:草稿猜得够不够准,以及当下有没有闲置算力供它挥霍。两者缺一,收益就会被草稿自身的开销吃掉。
介于两者之间的情况,别靠猜。实测平均接受长度,再结合当前并发下 GPU 是访存受限还是算力受限来判断。