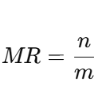声明:本文主要参考公开资料整理撰写,如有错漏,欢迎评论交流~
1. 从逐 Token Decode 说起
大语言模型生成文本时,Decode 阶段具有严格的自回归依赖:只有得到当前 Token,才能计算下一个 Token。KV Cache 可以避免重复计算已经出现的上下文,但没有消除 Token 之间的串行依赖。
对于大模型,单个 Decode Step 往往只处理很少的 Token,却要读取大量模型权重,因此常呈现 memory-bound 特征。投机解码的目标,就是在不跳过 Target Model 校验的前提下,让一次 Target Forward 尽可能推进多个 Token。
2. 投机解码:Draft 负责猜,Target 负责判
典型的投机解码包含一个轻量 Drafter 和一个最终负责生成质量的 Target Model。Drafter 先提出最多 K 个候选 Token,Target Model 再用一次批量 Forward 计算这些位置的 logits,并 从前向后 决定哪些候选可以接受。
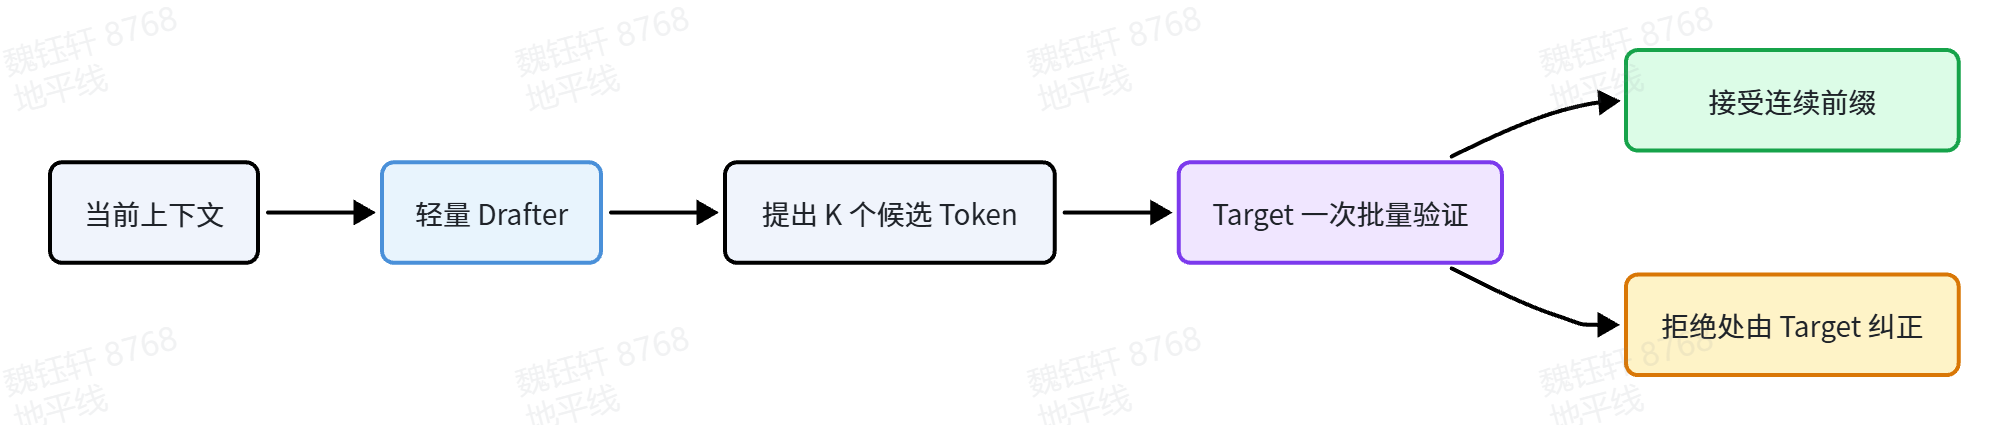
当每轮最多起草 K 个 Token 时,平均接受长度的范围是 1 到 K+1;其中“1”就是 Target 自己产生的 bonus token。
3. 为什么需要 EAGLE/EAGLE3
普通小型 Draft Model 虽然比 Target Model 便宜,但它与 Target 是两个独立模型。模型越小,起草越快,却可能越不了解 Target 的真实生成倾向,导致接受率下降;模型越大,接受率可能提高,但起草成本也随之增加。
EAGLE 的切入点是:Target Model 在上一轮计算中已经产生了信息密度很高的隐藏状态,与其让 Drafter 只看历史 Token,不如把 Target 的隐藏特征也交给 Drafter。
3.1 EAGLE:在特征空间里做自回归外推
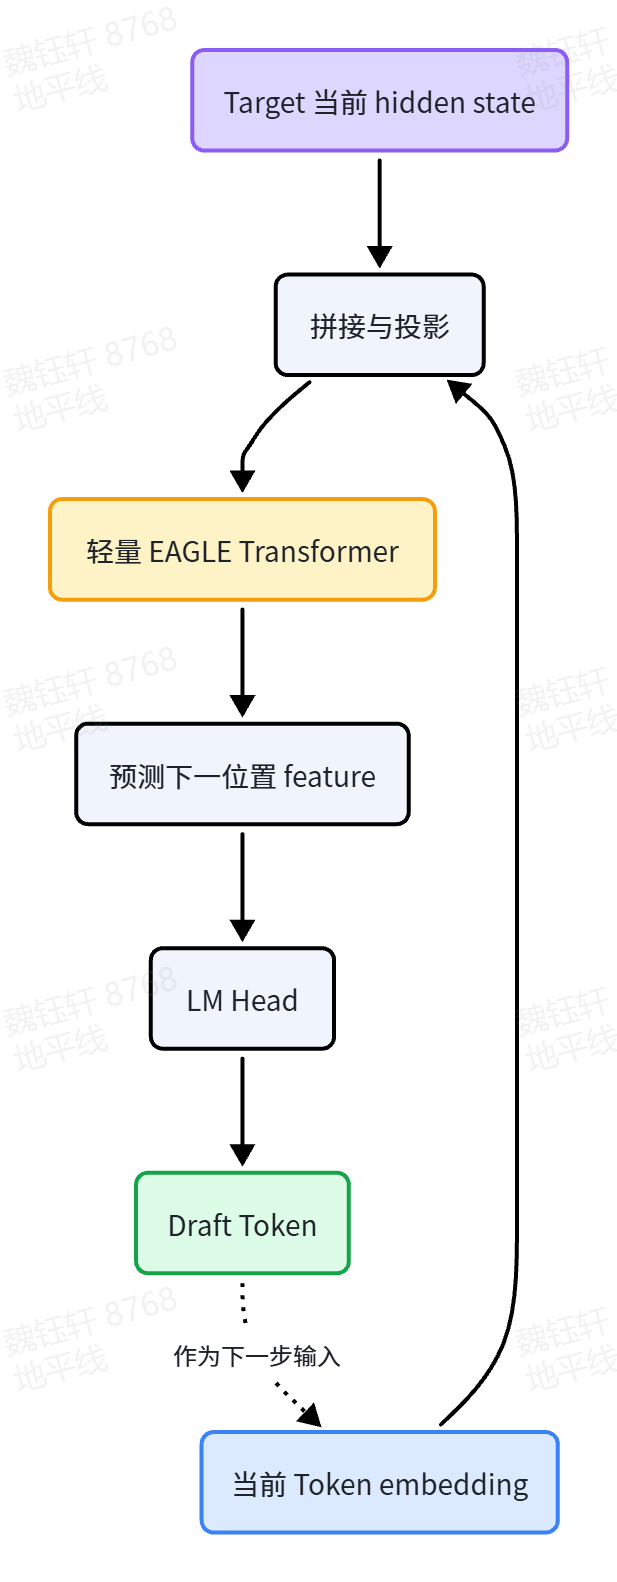
“Feature Extrapolation(特征外推)”是理解 EAGLE 的关键。Token 是离散结果,而隐藏特征包含更丰富的上下文信息。Drafter 借助 Target 的特征进行预测,通常比只依赖 Token 序列的小模型更容易贴近 Target,从而争取更高的接受率。
3.2 EAGLE-3:从单一最终特征走向多层特征融合
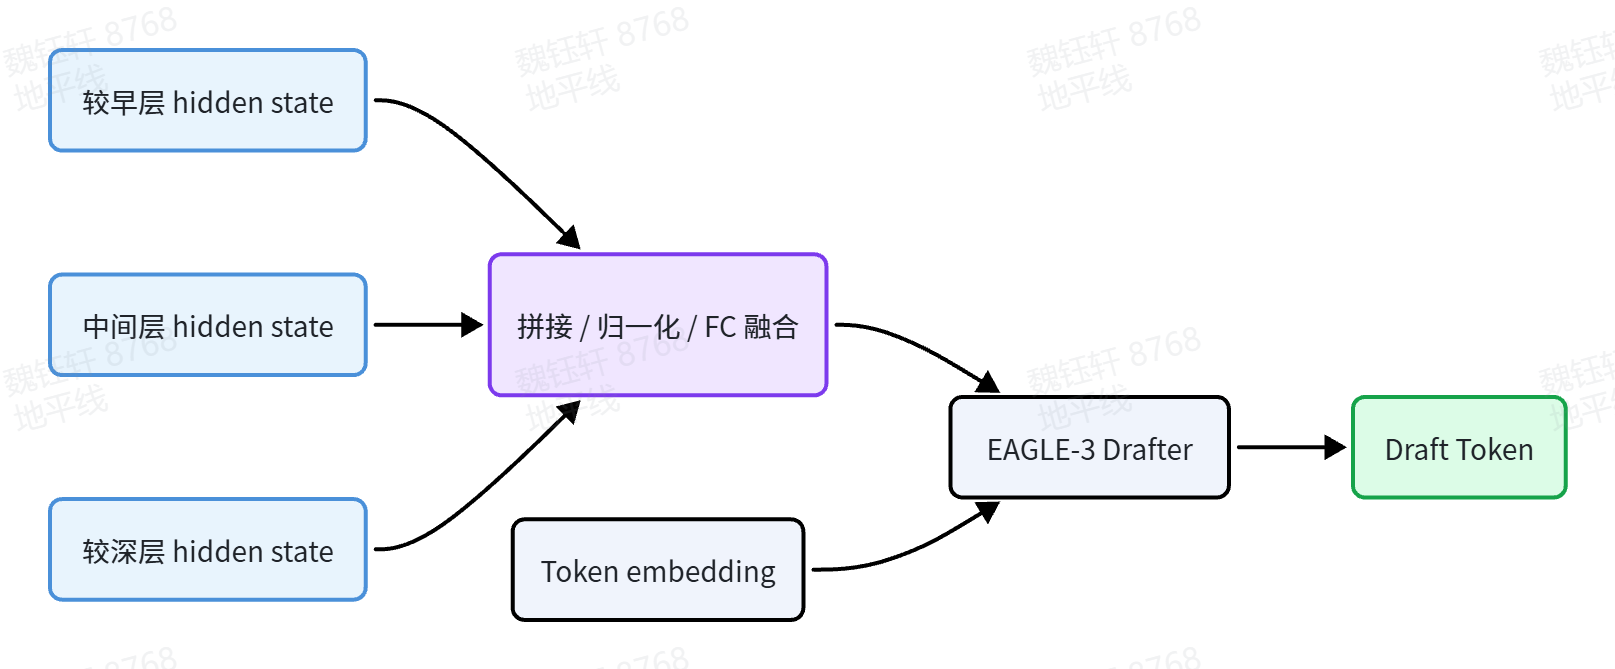
EAGLE-3 延续了特征级 Drafter 的思路,但进一步使用 Target Model 的多个辅助隐藏状态。不同深度的 Transformer 层携带的信息侧重点不同:较浅层更接近局部和词法信息,中间层逐步形成语义表示,较深层更贴近最终预测。将多层特征融合后,Drafter 可以获得比单一末层状态更丰富的条件信息。
3.3 EAGLE 与 EAGLE-3 有什么不同
对比维度 | EAGLE | EAGLE-3 |
|---|---|---|
核心输入 | 当前 Token embedding 与 Target hidden state | 当前 Token embedding 与一个或多个 Target 辅助 hidden states |
特征来源 | 通常以最终隐藏特征为主 | 典型实现融合多个层级的隐藏特征 |
vLLM 方法名 | method="eagle" | method="eagle3" |
默认 Draft 方式 | 自回归、逐步生成 K 个候选 | 自回归、逐步生成 K 个候选 |
Target 职责 | 批量验证并决定最终输出 | 批量验证并决定最终输出 |
EAGLE-3 的主要改进点是 Drafter 获得了更丰富的 Target 特征,而不是取消 Target Verification,也不是天然把所有候选 Token 改成一次并行生成。
4 为什么不会牺牲生成正确性
投机解码中,Drafter 只提供候选,最终输出仍由 Target Model 的 logits 和验证算法决定。Drafter 猜错的直接后果是接受长度变短,而不是错误 Token 被无条件写入结果。
在 greedy decoding 下,可以直观理解为逐位置比较 draft token 是否与 Target 的选择一致;一旦不一致,就在该位置使用 Target 的结果。在概率采样下,需要使用与配置相匹配的拒绝采样流程,才能保持目标采样分布。
5 性能收益取决于什么
EAGLE 的收益来自一个权衡:用较便宜的 Draft 计算,换取更少的 Target 串行 Decode Step。决定最终加速效果的不是某一个指标,而是以下因素共同作用:
- Draft 成本:Drafter 越轻、生成 K 个候选越快,额外开销越小。
- 接受率:提出的候选中有多少被 Target 接受。
- 平均接受长度:每轮验证实际输出多少 Token,包含 bonus token。
- 候选K 的大小:候选K 太小,减少的串行步数有限;候选K 太大,Draft 与验证开销会上升。
6 EAGLE 与 KV Cache 的关系
KV Cache 与 EAGLE 优化的是两个不同维度。KV Cache 复用已经计算过的历史 K/V,避免每次 Decode 重算全部上下文;EAGLE 尝试预测未来 Token,让一次 Target Verification 推进多个位置。
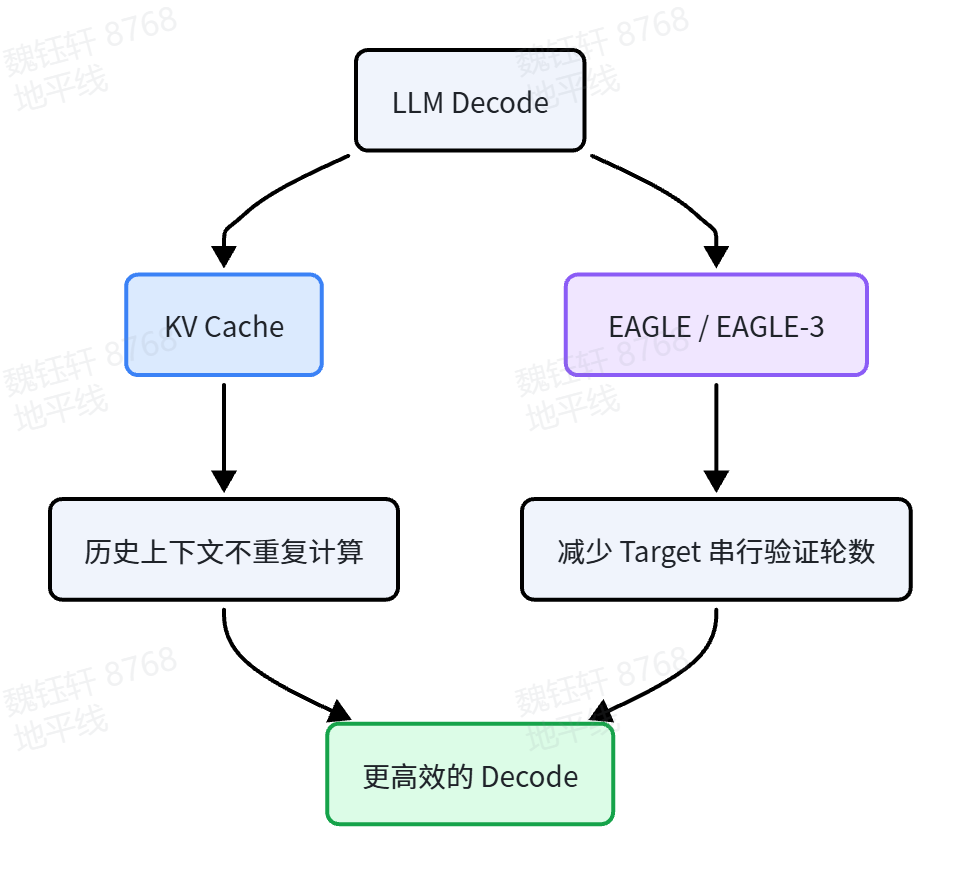
实现上,Target 与 Drafter 还可能分别维护自身需要的 KV Cache。EAGLE 并不是 KV Cache 的替代品,而是在 KV Cache 基础上进一步降低 Decode 的串行性。
7. 适用场景与局限
部署时还需要考虑 Drafter checkpoint 与 Target 的模型家族、词表、隐藏维度和辅助层配置是否匹配;Draft 模型会增加权重和 KV Cache 占用;EAGLE-3 还要求 Target 实现能够导出所需的辅助隐藏状态。
8. 一句话理解 EAGLE / EAGLE-3
EAGLE 利用 Target 已计算的隐藏特征,让轻量 Drafter 在特征空间中自回归预测未来 Token;EAGLE-3 进一步融合多个层级的 Target 隐藏特征。候选最终仍由 Target 批量验证,从而在保持 Target 生成语义的前提下,减少串行 Decode 轮数。
9. 参考资料
- vLLM:docs/features/speculative_decoding/eagle.md
- vLLM:docs/features/speculative_decoding/README.md
- vLLM:docs/features/speculative_decoding/acceptance_metrics.md
- vLLM:docs/features/speculative_decoding/dynamic_speculative_decoding.md
- vLLM 实现:vllm/v1/spec_decode/llm_base_proposer.py
- vLLM 实现:vllm/model_executor/models/llama_eagle.py、llama_eagle3.py
EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty
EAGLE-3: Scaling up Inference Acceleration of Large Language Models via Training-Time Test