hrt_model_exec infer 已经正常结束,为什么最终检测框还是看起来“不对”?
很多时候,问题在于我们把三件不同的事混在了一起:
实验环境与输入
本次使用 J6M 开发板,实际运行时日志显示:
模型输入是 NV12 拆分后的两个张量:
模型有三路输出:
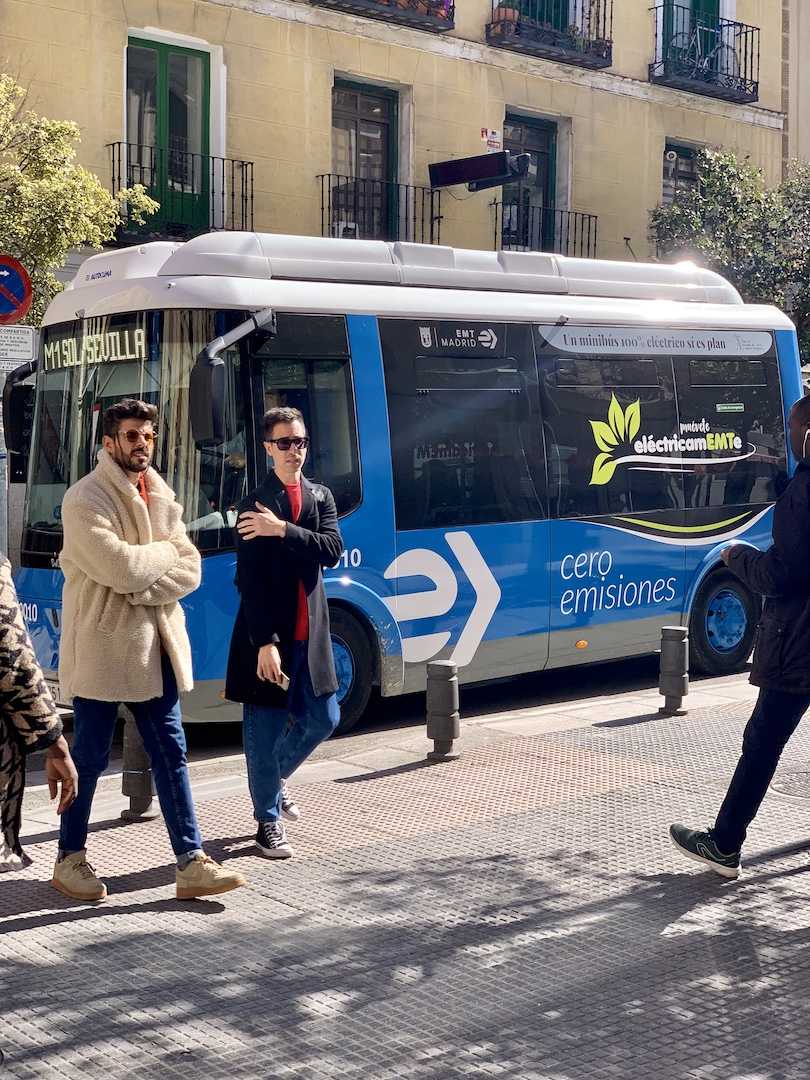
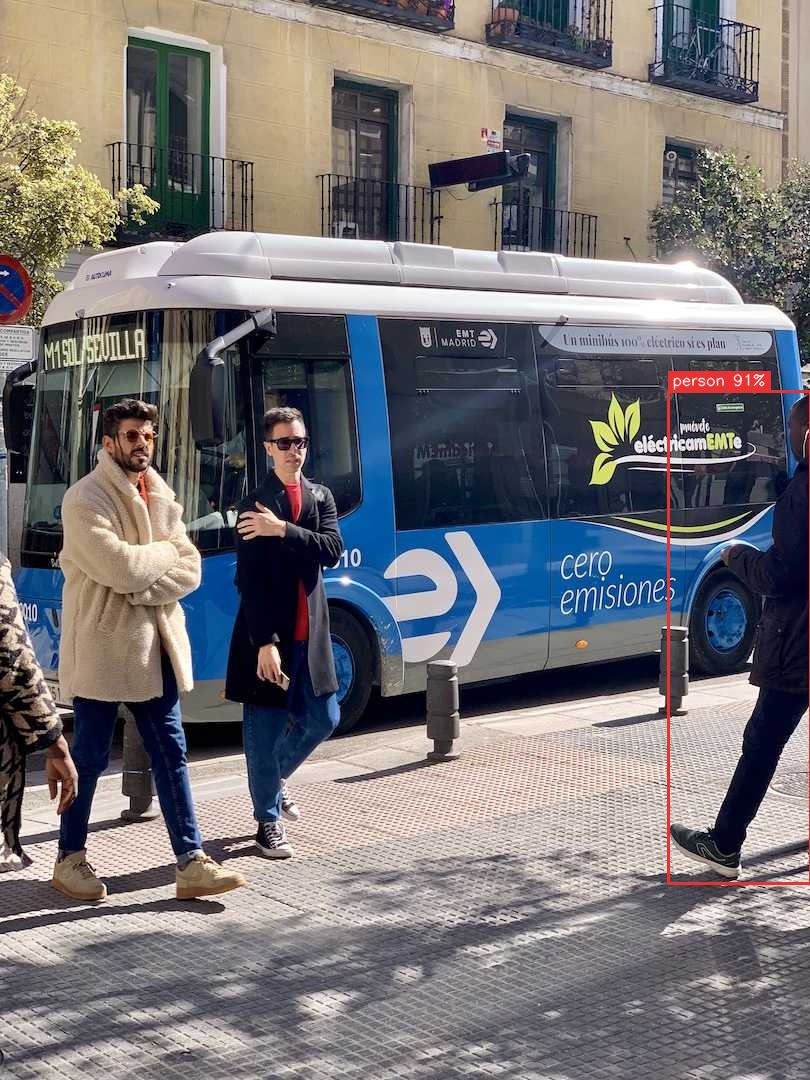
图 1:本次实测使用的 input_bus.jpg。
图片中有一辆公交车、几名行人,以及右侧被截断的行人。它适合观察阈值变化后,哪些目标会消失。
先确认:HBM 实际收到了什么
本次得到 5 个文件,合计约 26 MB:
这一步检查工具实际整理并送进模型的输入数据。
对 dump 文件做基本数值检查后,得到以下结果:
张量 | 有效元素数 | 最小值 | 最大值 | NaN / Inf |
|---|---|---|---|---|
images_y | 409600 | 0 | 255 | 0 / 0 |
images_uv | 204800 | 67 | 193 | 0 / 0 |
output | 1632000 | -21.372129 | 6.607379 | 0 / 0 |
729 | 408000 | -19.035624 | 6.802583 | 0 / 0 |
741 | 102000 | -14.909419 | 6.349002 | 0 / 0 |
三个输出文件的元素数分别与模型输出 shape 一致:
这里能确认几件事:
Y、UV 输入都不是空数据;
三路模型输出都不是全零;
输出中没有 NaN 或 Inf;
输出出现负数和大于 1 的值,说明这些文件是待后处理解释的原始张量。
这一步只能说明输入与 HBM 输出没有出现明显的数值异常。检测框是否合理,还要继续看后处理。
同一份原始输出,为什么检测框数量会不同
先使用较低的置信度阈值:
输出为 6 个目标:
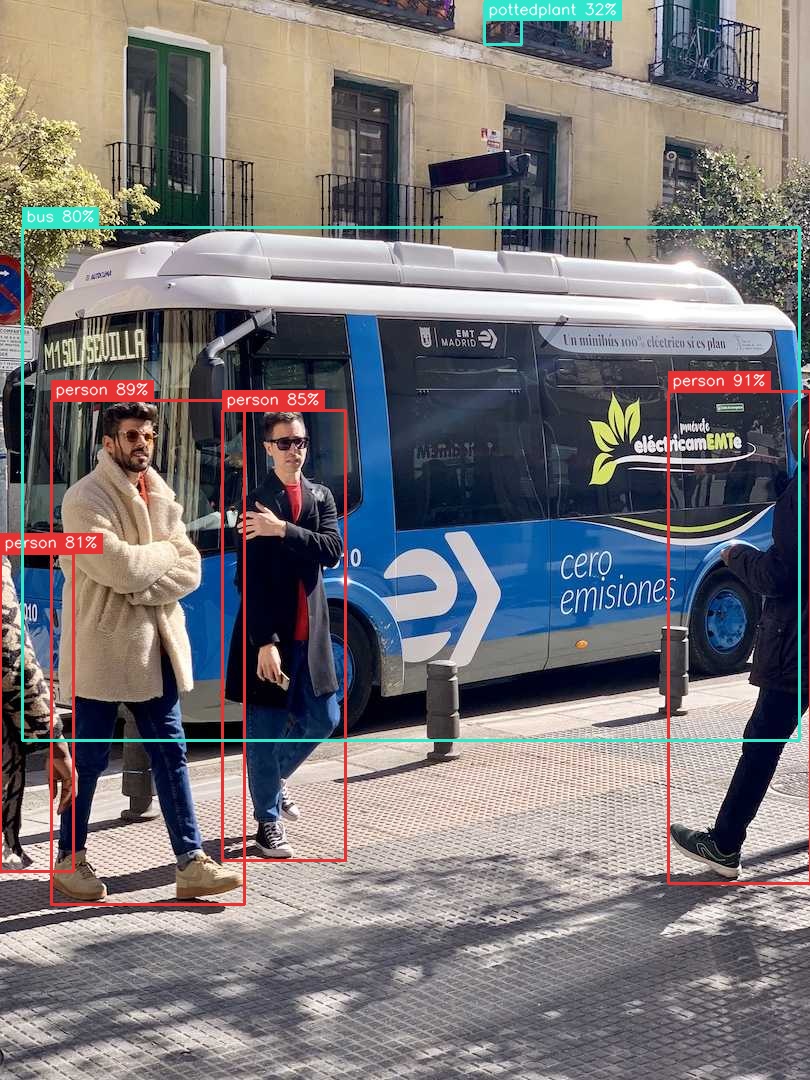
接着只修改置信度阈值,HBM、输入图片与 NMS 阈值都保持不变:
结果只剩一个目标:
置信度阈值 | 最终保留目标数 | 可见现象 |
|---|---|---|
0.25 | 6 | 公交车、4 名行人和低置信度目标都被绘制 |
0.90 | 1 | 只保留置信度 0.905451 的右侧行人 |
这张对比图比单纯看日志更直观:把阈值提高到 0.90 后,图中非常明显的公交车也消失了,因为它的分数是 0.801505。阈值并不是越高越好;它决定了应用愿意保留多低分的候选目标。
用三道边界定位问题
遇到“模型跑通但结果不对”时,我建议不要一开始就怀疑 HBM,也不要马上全量 dump 中间节点。先沿着下面三道边界排查:
现象 | 优先检查的位置 | 可使用的证据 |
|---|---|---|
图像颜色、尺寸或内容明显异常 | 输入边界 | images_y、images_uv 的有效元素数与数值范围 |
输出全零、出现 NaN/Inf,或输出规模与模型 shape 不符 | 模型输出边界 | 三路最终输出文件、model_info |
原始输出正常,但框的位置、类别或数量异常 | 后处理边界 | anchor、类别表、阈值、NMS、resize / 坐标还原逻辑 |
这次实测已经排除了前两类明显问题:输入数据存在,三路输出有限且非全零。随后在同一份 HBM 和同一张图片上修改阈值,最终框数从 6 变成 1,说明可视化结果确实受后处理配置直接影响。