博客算法工具链【大模型】Attention 基础:Self、Causal、MHA、GQA 与 MQA 的关系

【大模型】Attention 基础:Self、Causal、MHA、GQA 与 MQA 的关系

no_name2026-10-08
14
0

1. 从大模型推理说起

Attention 是 Transformer 的核心计算模块。

对于 LLM 部署来说,很多看似不同的问题,其实都和 Attention 有直接关系:

  • 为什么 LLM 推理需要 KV Cache?

  • 为什么 Decode 阶段越来越受内存带宽限制?

  • 为什么 MQA/GQA 可以降低 KV Cache?

  • 为什么部分 Qwen、Llama 系列模型采用 GQA?

  • 为什么 Prefill 和 Decode 的 Attention 计算方式不同?

  • 为什么 FlashAttention 能提升 Attention 性能?

  • 为什么长上下文会带来巨大的显存压力?

理解这些问题之前,首先需要建立一个重要认识:Self-Attention、Causal Attention、MHA、GQA、MQA、FlashAttention 并不是同一维度的概念。

它们分别描述 Attention 的:

  • 数据来源

  • 可见范围

  • Q/K/V Head 组织方式

  • 计算实现方式

因此它们可以组合在一起。

例如一个 LLM 完全可以采用:Causal Self-Attention + GQA + FlashAttention

2. 一次 Attention 计算发生了什么

标准 Attention:

可以拆成三个步骤。

2.

2.1 Q 与 K:计算相关性

QKᵀ得到:当前 Query 和每个 Key 的相关程度。

可以简单理解为:

  • Q:我现在想找什么?

  • K:我这里有什么?

  • QK:我和你相关吗?


2.2 缩放、掩码与 Softmax

常见公式为:Softmax(QKᵀ),完整的缩放点积 Attention 在 Softmax 前通常还要除以 √d_head,并根据任务添加 Mask:Softmax((QKᵀ/√d_head) + mask)。
公式中省略 缩放和 Mask,只能用于说明权重从何而来;√d_head 是 "方差归一化系数",它把 QKᵀ 点积的幅度锁在常数级,防止维度变大后 softmax 饱和、梯度消失;在 decoder-only LLM 中,causal mask 会屏蔽未来位置。

表示当前 Query 更关注 Token B。


2.3 用权重聚合 V

也就是:Q/K 决定“关注谁”,V 决定“拿什么信息”。

因此可以记住:Q 和 K 决定注意力权重,V 提供被加权汇总的信息。缩放、掩码与 Softmax 决定这些权重如何计算。


3. Self-Attention:同一序列内部的信息交换

Self-Attention 的核心特点:Q、K、V 来自同一个序列。

例如:

如果暂时不加可见性约束,同一序列各位置可以彼此建立联系;但 decoder-only LLM 还会叠加 Causal Mask,位置 i 只能读取到 i 及之前的位置。

Self 决定 Q/K/V 的来源,是否能看见未来由 Mask 单独决定。

因此 Self-Attention 可以理解成:一个序列内部的 Token 互相“看”。优势是:在没有其他限制时,Self-Attention 可以建模同一序列中不同位置的关联。decoder-only 模型通常另用 causal mask 限定可访问的历史位置。

标准 Self-Attention 的核心计算:QKᵀ。在标准 Self-Attention 中,输入序列长度为 N 时,首先计算 Query 与所有 Key 的相似度:S = QKᵀ
对于单个 Head,Q 和 K 的 Shape 分别为 [N, d],因此得到的注意力得分矩阵 S 为:
也就是说,每个 Token 都需要与序列中的其他 Token 计算注意力得分,因此全量 Prefill 阶段的 QK 计算量通常随 N² 增长。
如果采用朴素实现,还可能显式保存这个 N×N 的注意力矩阵作为中间激活,使内存开销也随 N² 增长。但这部分矩阵只是 Attention 计算过程中的临时结果,并不是 KV Cache。
实际实现中,FlashAttention 等分块 Attention 算法不会完整保存 N×N 注意力矩阵,而是通过分块计算和在线 Softmax (Online Softmax)降低中间激活的内存占用。因此,Attention 的计算复杂度与中间矩阵的显式存储开销需要区分开来。

另一方面,KV Cache 保存的是已经计算得到的 Key/Value,它随缓存 Token 数量线性增长,注意与上面的Attention 计算区分开来。

综合来看:长上下文带来的核心问题并不只有“KV Cache 变大”:Prefill 阶段的 Attention 计算量通常随序列长度平方增长,而 KV Cache 容量则随 Token 数量线性增长;FlashAttention 进一步解决了朴素实现需要显式保存 N×N 注意力矩阵所带来的额外内存开销。

3.1 Causal Mask:同一序列也不能偷看未来

LLM 是自回归生成:

生成“北”时,模型不能提前看到“京”,因此需要 Causal Attention。
它的核心规则:当前位置只能看到当前位置以及之前的 Token。例如:

对应 Causal Mask:


3.2 Self 与 Causal 是两个维度

这是最容易混淆的地方。

  • Self-Attention 描述的是:Q/K/V 来自哪里?
  • Causal Attention 描述的是:Q 可以看到哪些 K?

因此二者不是互斥关系。
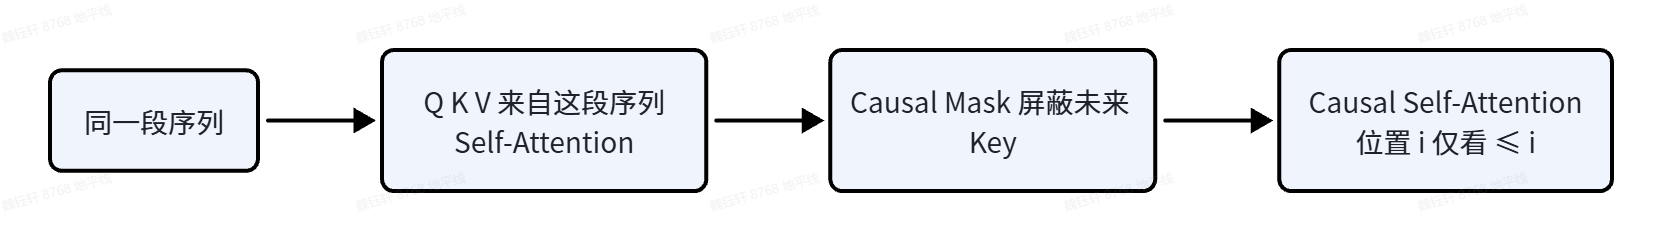
LLM 中最常见的就是:Causal Self-Attention,也就是:

4. Cross-Attention:从另一序列读取信息

4.1 Cross-Attention简介

上一节说的 Self-Attention,是同一段序列的各位置交换信息。 可如果当前序列还需要读取另一份已经准备好的信息,例如翻译时的原文表示,或者某些多模态模型中的图像特征,只在自身序列内部查找就不够了。这时可以使用 Cross-Attention(交叉注意力):由正在处理的一侧生成 Query(Q),由另一侧的信息生成 Key(K)和 Value(V),让当前的 Q 去另一侧的 K/V 中按相关性读取信息。
所以,“Cross”说的是Q 与 K/V 的来源不同,不是换掉了 Attention 的计算方式。它仍先用 Q 与 K 求匹配权重,再用这些权重加权汇总 V;结果回到发起查询的一侧,帮助它更新当前位置的表示。

以 Encoder–Decoder 翻译模型为例:输入英文句子后,Encoder 先把原文变成一组上下文表示。Decoder 逐步生成中文。假设 Decoder 正准备生成某个中文位置,它可以从自身当前的 hidden state 生成 Q;Encoder 的原文表示则提供 K 和 V。Q 会判断哪些原文位置更相关,再取回相应的 V,供 Decoder 形成该位置的新表示和后续预测。
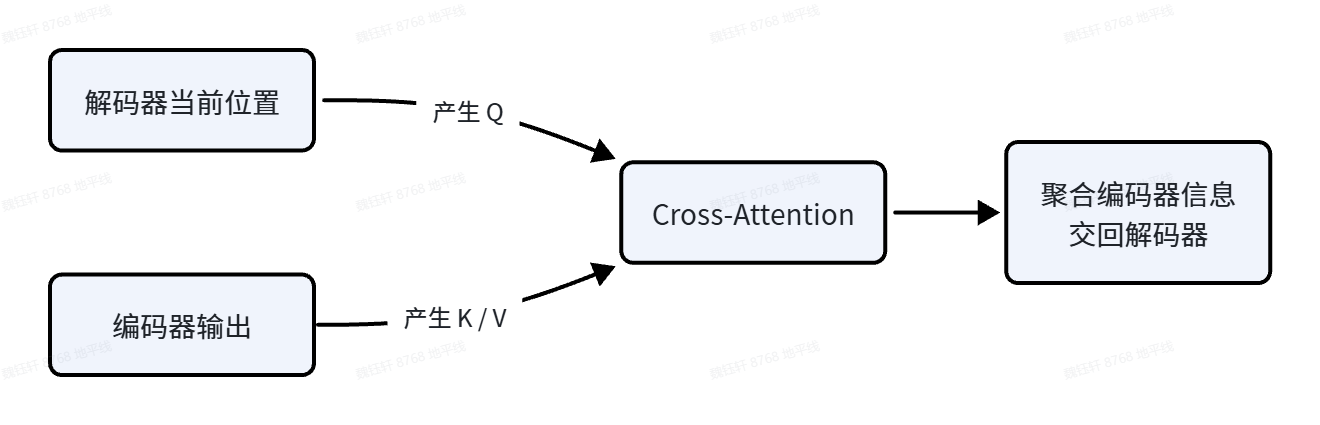
上图:Decoder 产生 Q,Encoder 产生 K/V,Cross-Attention 汇总后的信息再交回 Decoder。

Decoder 通常还会有自己的 Causal Self-Attention,用来读取已生成的目标序列;这与读取 Encoder 信息的 Cross-Attention 是两个不同步骤。

因此,对比Self-Attention和Cross-Attention时只需先问一句:当前 Q 到哪里找 K/V?
  • 如果 Q、K、V 都来自同一段序列,这是 Self-Attention;

  • 如果 Q 来自 Decoder,而 K/V 来自 Encoder 输出,就是 Cross-Attention。

至于能看到对方哪些位置,要继续看模型的 Attention Mask 和具体实现;“Cross”本身不等于“无条件看到全部 Token”。


4.2 什么时候会用到 Cross-Attention

Encoder–Decoder 模型是最直观的应用:Decoder 生成自己的序列时,一边利用目标序列的历史信息,一边通过 Cross-Attention 读取 Encoder 已编码的输入。例如一些语音识别模型也采用这种结构,由文本 Decoder 读取音频 Encoder 的输出。
但纯文本、Decoder-only LLM 的主干通常以 Causal Self-Attention 为主,没有为了“读取另一条序列”而必然设置独立的 Cross-Attention 层。不要因为模型在回答用户问题,就把它处理 Prompt 中历史 Token 的 Self-Attention 叫成 Cross-Attention:这些 Token 仍处于同一条模型序列中。
多模态模型则要看具体怎么融合。一种设计让文本侧状态生成 Q、视觉或音频侧编码结果提供 K/V,此时确实存在 Cross-Attention。另一种设计先把视觉表示转换为可与文本拼接的输入 embedding,让二者进入同一个 Decoder 序列,通过 Self-Attention 交互;它虽然跨越了模态,却不因此自动成为一个独立的 Cross-Attention 层。
所以判断一个 VLM 是否用了 Cross-Attention,不是看输入里是否出现图像,而要看模型结构中文本的 Q 是否在独立 Attention 层读取另一侧的 K/V。如果是在共同的 Token/Embedding 序列里做 Attention,仍应按该层的 Self-Attention 机制来描述。
本节可以归纳为:Self-Attention 是“在自己的序列中找信息”,Cross-Attention 是“拿当前侧的 Q,向另一侧已有的 K/V 查询信息”。两者都使用 Attention 权重聚合 V,但适用场景和 K/V 来源不同。

5. 多头与 KV 共享:MHA、GQA、MQA

前面讲的是 Attention 的基本形式。

实际上 Transformer 通常不会只计算一次 Attention,而是拆成多个 Head。

例如:一个 hidden state 会分别投影出多个 Q、K、V Head。每个 Q Head 在允许的位置上计算自己的注意力,再将多个 Head 的结果拼接、经输出投影融合。以 32 个 Q Head 的 MHA 为例,通常也有 32 个 K Head 与 32 个 V Head。

每个 Head 都有自己的:Q、K、V,例如:

这就是:MHA(Multi-Head Attention)

5.1 多 Head 能学习什么

不同 Head 可以学习不同类型的关系。例如:

  • 某个 Head 更关注:主语 ↔ 谓语

  • 另一个 Head 更关注:代词 ↔ 前文实体

  • 还有 Head 可能关注:局部 Token

因此,多 Head 可以提供更丰富的表示能力。


5.2 多 KV Head 的缓存代价

核心问题:KV Head 太多。假设:

那么 KV Cache 也需要保存 32 组 K/V。随着:

  • Batch 增大

  • Context 变长

  • Layer 增多

KV Cache 会迅速膨胀。因此出现了 MQA 和 GQA。


5.3 MQA:所有 Q Head 共享一组 KV

MQA:Multi-Query Attention。核心思想:以 32 个 Q Head 为例,

也就是说:MQA 仍有 32 条独立 Q,但这些 Q 共享同一组 K/V;减少的是 KV Head 数,而不是把 32 条 Q 变成一条。所有 Query Head 共享同一组 K/V。


收益是直接减少了 KV Head:
  • MHA:32 KV Heads

  • MQA:1 KV Head

因此 KV Cache 理论上可以大幅降低。这对 Decode 尤其重要。因为 Decode 每生成一个 Token,都需要读取历史 KV Cache。KV Cache 越大:需要搬运的数据越多。

因此 MQA 可以降低:

  • KV Cache 显存

  • KV Cache 读取量

  • Memory Bandwidth 压力


问题也很明显:所有 Q Head 共享 KV,表达能力可能受到限制。
因此工程上逐渐出现了一个折中方案:GQA

5.4 GQA:分组共享 KV

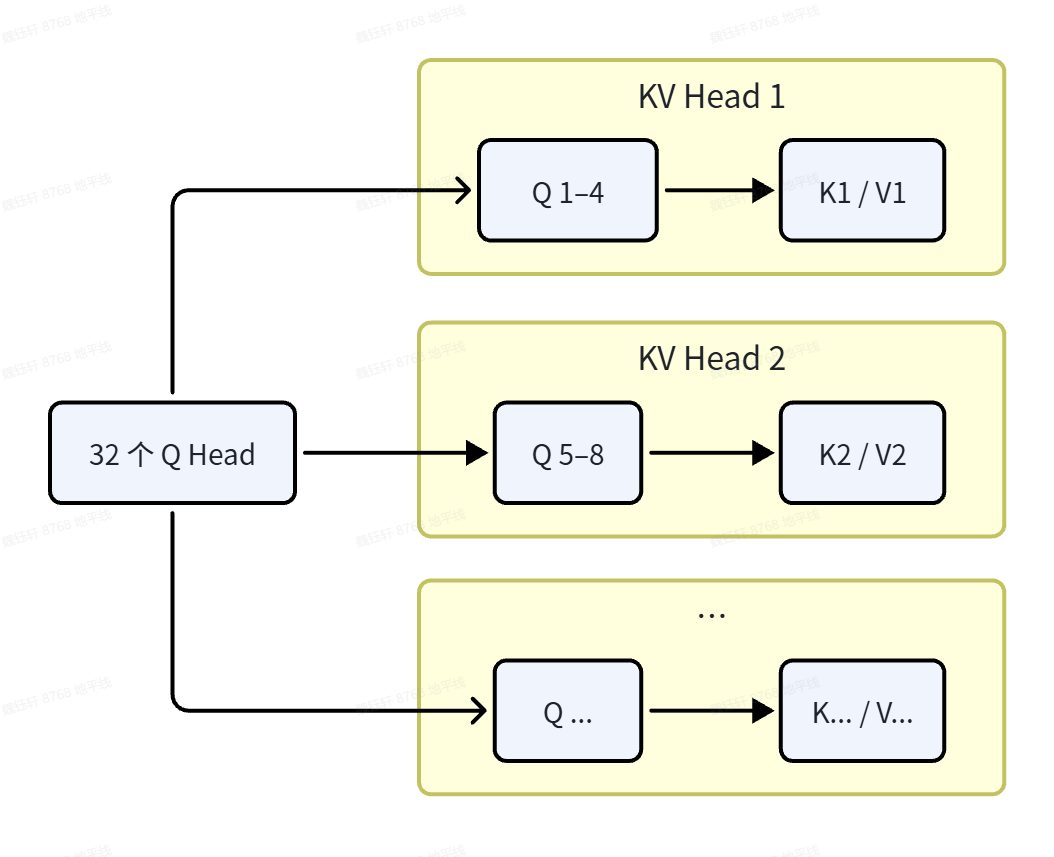
GQA:Grouped-Query Attention。核心思想:多个 Query Head 共享一个 KV Head,但不是所有 Q 共享一个 KV。例如:
  • Q:32 Heads

  • KV:8 Heads

可以理解为:

也就是:4 个 Q Head 共享一个 KV Head。

5.5 同一例子看清三种 Head 布局

可以用这下表记忆:

结构

Q Head

KV Head

MHA

32

32

GQA

32

8

MQA

32

1

在相同前提下,KV Head 越少,缓存占用与读取量通常越低,Q 对 KV 的共享程度越高。

模型质量是否受到影响取决于架构与训练,不能仅由 Head 数判断。

在其他条件相同(层数、序列长度、每头维度和缓存精度)时,KV Cache 与 KV Head 数近似成正比;头数减少与模型质量之间是设计权衡,不意味着 MQA 一定掉点或 GQA 一定最优。


5.6 为什么 KV Head 数影响 Decode

LLM Decode 阶段有一个特点:每次通常只生成 1 个 Token,但是这个 Token 需要访问大量历史 KV。

每一步 Decode 只对当前少量 Query 计算注意力,却仍须读取对应的历史 K/V,所以 Decode 很容易受到Memory Bandwidth限制。

降低 KV Head 数可以减少需要存取的历史 K/V。对相同缓存宽度、长度与数据类型的模型,GQA 减少 KV Head,可直接减轻这一部分的缓存压力。

对于给定缓存精度和 Head 维度,更少的 KV Head 通常意味着更小的 KV Cache 和更低的 KV 读取量。

因此:GQA 不只是模型结构设计,对 LLM 推理部署也非常重要。
把“模型结构”和“Kernel 实现”分开算账。例如一个 32 个 Q Head 的模型:MHA 使用 32 个 KV Head,GQA 使用 8 个,MQA 使用 1 个。在每头维度、Token 数、层数、数据精度相同的假设下,它们的 KV Cache 容量大致为 32:8:1。单层每条序列的 KV 缓存字节数可估算为 2 × N × H_kv × d_head × bytes_per_element。这只是 KV 的容量比例,不是端到端吞吐量比例;模型权重、Attention 算法和调度同样有成本。

6. 总结

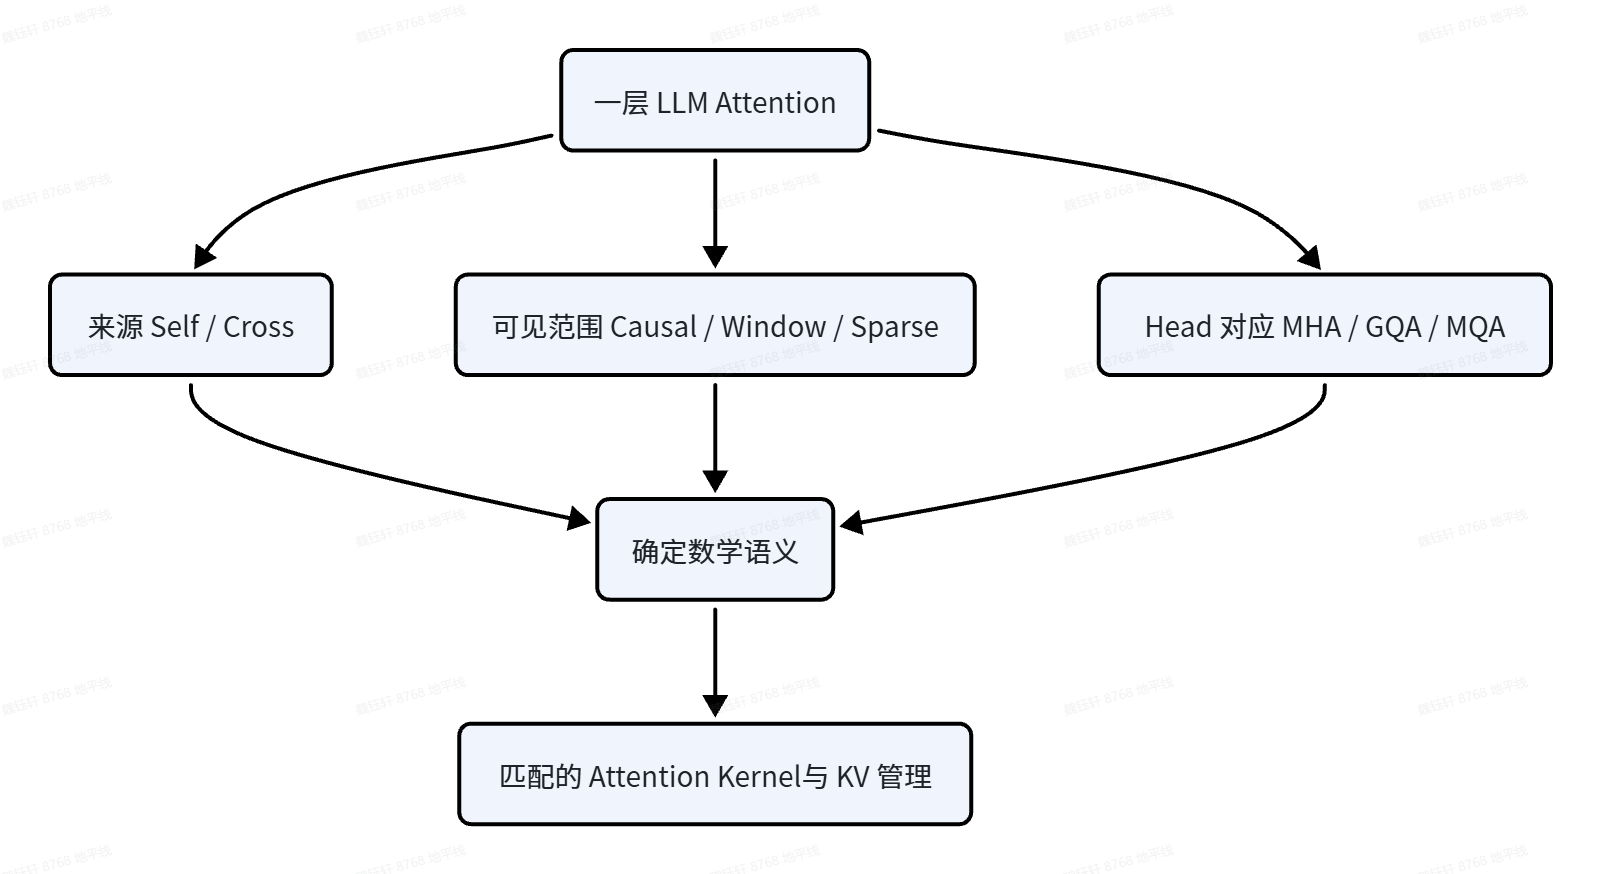
用一张图统一起来:

将术语放在四个相互独立的维度:

  • Q/K/V 来自同一序列还是不同序列(Self/Cross);

  • 每个 Query 能访问哪些位置(Causal/双向/局部);

  • Q 与 KV 各有多少 Head(MHA/GQA/MQA);

  • 实现如何组织计算与缓存(具体 Attention Kernel、KV 分页与前缀复用)

前面三项是结构或可见性语义,最后一项是工程实现。

概念

解决什么问题

Self-Attention

Q/K/V 来自同一序列

Cross-Attention

Q 与 K/V 来自不同序列

Causal Attention

限制不能看到未来 Token

MHA

每个 Q Head 有独立 KV

GQA

多个 Q Head 共享 KV

MQA

所有 Q Head 共享 KV

算法工具链
社区征文杂谈
评论0
0/600