把六份 UCP 代码交给真实 SDK:一次编译与链接对照
上次vol4做 OE-Skills 测评时,我让 Agent 生成了六份征程6 UCP C++ 代码,再检查它们有没有写对接口名称、内存处理和错误退出流程。那次还做了一项机器检查:用自己整理的简化头文件,让编译器检查代码的语法和接口引用,结果是四份通过、两份报错。
这次我把同样六份代码交给真实 SDK,分别执行编译和链接。原版结果变成了三份通过、三份失败。
多出来的失败是 G02。它使用的一个量化枚举名,在真实 SDK 里不存在,却被我之前的简化头文件定义了出来。代码和检查工具用了同一个错误名字,于是旧检查没有把它拦住。
我意识到,除了检查生成代码,还需要检查自己拿来判断代码的依据。下面就从这六份代码开始,把复验过程和结果展开。
一、为什么还要检查这六份代码?
UCP 是应用程序使用地平线推理能力的一组接口。应用通过这些接口加载模型、查询输入输出要求、分配内存、提交推理任务,再取得结果和释放资源。
在前面里,我审查的是 Agent 生成的六份代码,包括最小单模型推理、动态读取模型输入输出、量化输出处理、两模型并发、错误处理,以及 Host/Target 场景下的 C++ 示例。代码里有完整的流程和大量注释,但实际使用时,每一个函数名、参数和数据类型都要符合项目所用的开发包。
上一轮没有使用真实 SDK 完成构建,而是自己整理了一组简化头文件,也就是 stub。它方便检查代码能否按照这些声明被解析,但这些声明是否与官方接口一致,还需要核实。
二、这次做到了哪一步?
先把编译和链接分开理解。
这轮流程是:
实验在本地官方 OE CPU 容器内执行。此次只构建代码,没有运行生成的推理程序。本次复验使用 AI Agent Codex 辅助完成,辅助工作包括构建脚本编写、接口核对与修复、日志分析、图表生成。
项目 | 实验设置 |
|---|---|
开发包与镜像 | OE 3.9.1,openexplorer/ai_toolchain_ubuntu_22_j6_cpu:v3.9.1 |
编译器与架构 | GCC 12.2.0,x86_64 |
头文件与库 | 随包 samples/ucp_tutorial/deps_x86/ucp/ |
代码标准 | 六份原代码使用 C++17,官方样例使用 C++11 |
构建方法 | 直接调用 GCC,分别保存编译与链接日志 |
三、原版结果:三份通过,三份在编译阶段失败
代码 | 主要内容 | 旧 stub 语法检查 | 真实 SDK 编译 | 原版严格链接 |
|---|---|---|---|---|
G01 | 最小单模型推理 | 通过 | 通过 | 通过,可执行文件 |
G02 | 动态查询模型输入输出、分配内存 | 通过 | 失败 | 未进入 |
G03 | 反量化函数与模拟输出示例 | 失败 | 失败 | 未进入 |
G04 | 两模型并发 | 通过 | 通过 | 通过,可执行文件 |
G05 | 错误处理与资源清理 | 通过 | 通过 | 通过,共享模块 |
G06 | Host/Target 回答中的 C++ 代码块 | 失败 | 失败 | 未进入 |
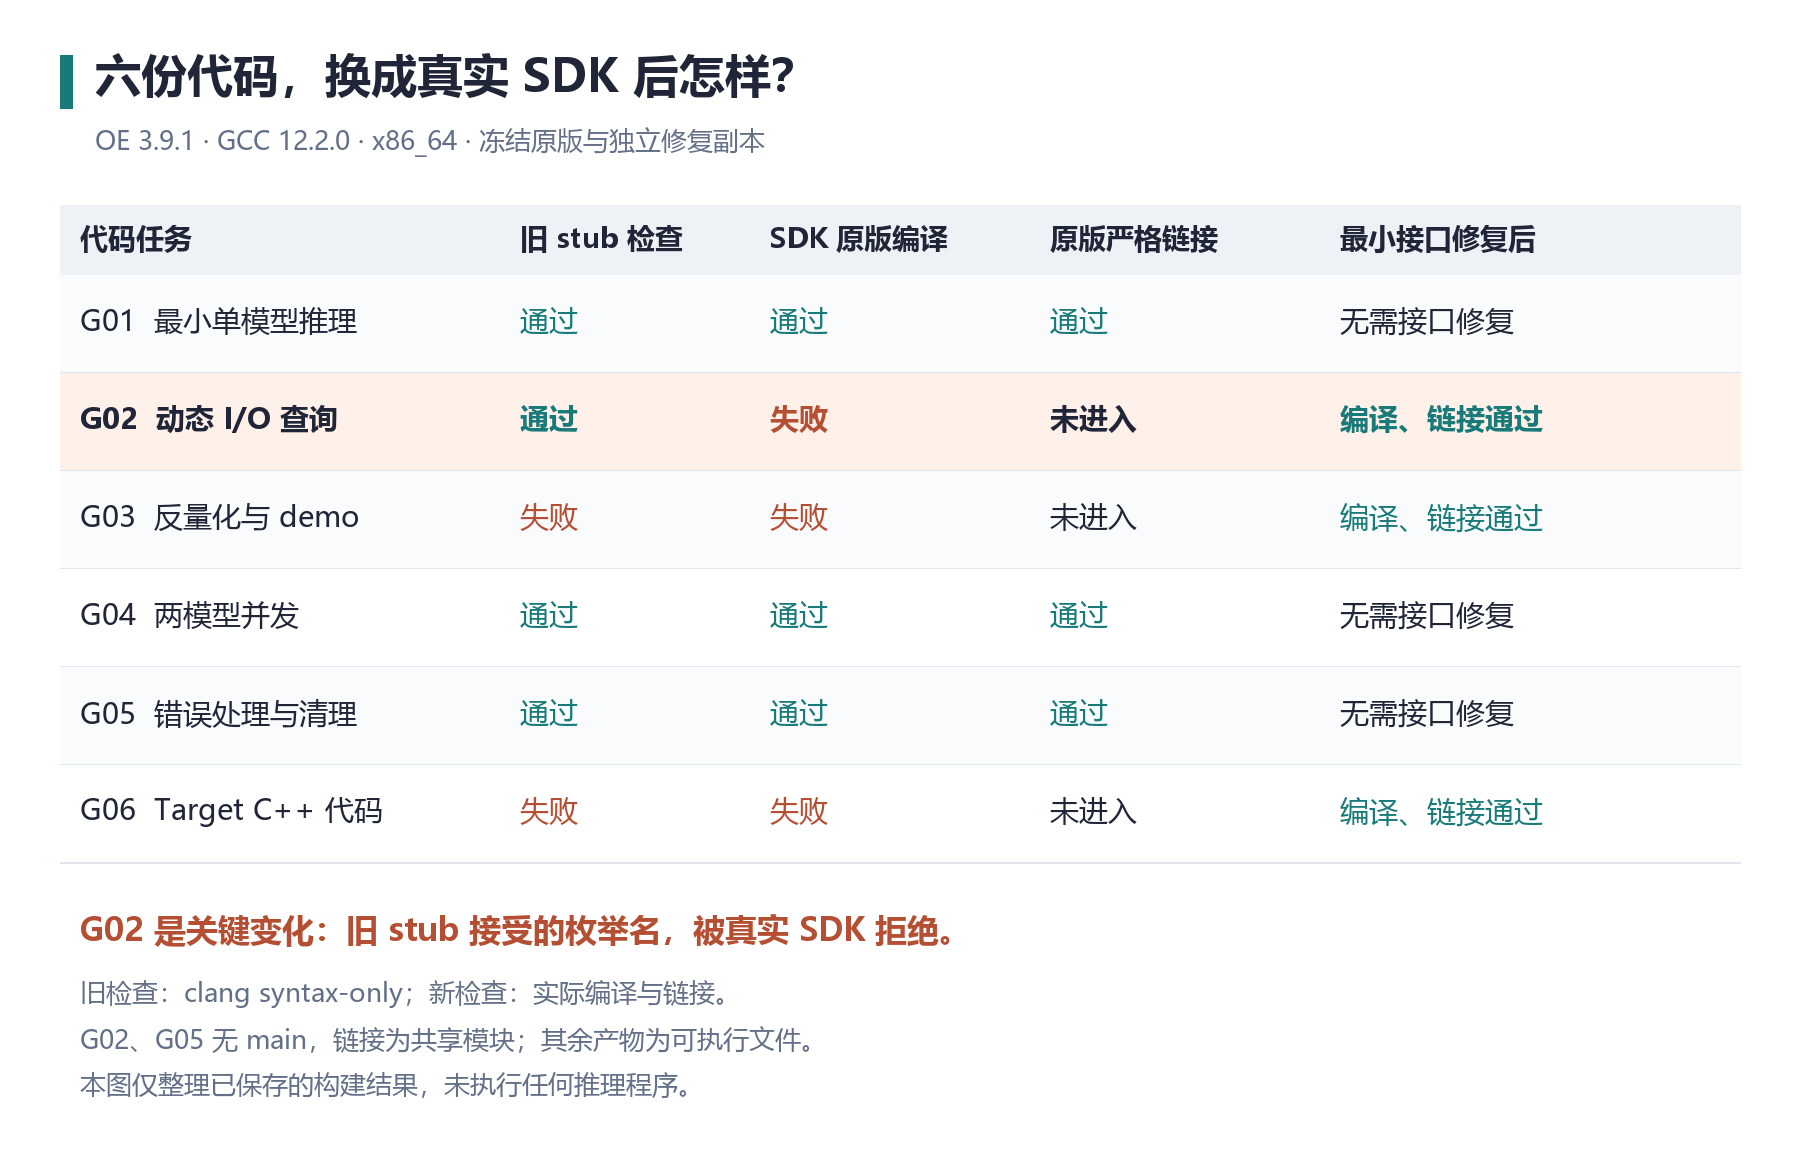
图1|六份固定代码的逐例结果。原版与修复副本分别记录;G02、G05 的链接对象是共享模块。图中结果来自保存的构建日志。
“未进入”表示编译已经失败,所以没有继续链接。原版通过编译和链接的是 G01、G04、G05。
这张表比较的是旧 stub 检查与新的 SDK 构建,编译器和检查方式也有变化。下面对 G02 的判断,会同时结合真实头文件、旧 stub、报错和补丁来说明原因。G06 本轮只检查 C++ 代码块,没有把原回答中的 Python 示例算进来。
四、G02:旧检查为什么放过了错误名称?
G02 会查询模型的张量属性,包括数据形状、内存步长、缓冲区大小和量化信息。它在判断量化类型时写了:
这段代码想表达的是:如果当前张量使用 scale 量化,就打印量化参数的数量。思路可以理解,问题出在用来表示量化类型的名称。
真实编译日志在这一行报错:
只改这一处后,G02 副本就通过了编译和严格链接。
回头看旧 stub,原因也很清楚。它的定义是:
我给编译器提供的头文件里,确实有代码使用的那个名字。因此旧编译器接受了它。生成代码的错误与 stub 的错误恰好吻合,检查就出现了漏检。
这次需要更正的是这部分检查依据:旧 PASS 是代码符合当时的简化声明;真实 SDK 则确认了 G02 使用的名称不兼容。核对具体接口时,实际开发包中的声明比根据命名习惯整理出来的名称更可靠。
五、G03 和 G06:接口修复分别改了什么?
G06 则先停在头文件引用上:
修复副本的主要变化如下。表中的写法针对本次 OE 3.9.1 SDK。
处理环节 | 原写法 | 修复后的写法 |
|---|---|---|
引用系统内存接口 | hobot/hb_sys.h | hobot/hb_ucp_sys.h |
分配可缓存内存 | hbSysAllocCachedMem(&mem, size) | hbUCPMallocCached(&mem, size, 0) |
维护缓存 | hbSysFlushMemCache(&mem, flag) | hbUCPMemFlush(&mem, flag) |
释放内存 | hbSysFreeMem(&mem) | hbUCPFree(&mem) |
释放模型资源 | 分别调用 hbDNNReleaseModelHandle 和 hbDNNReleasePackedHandle | 调用 hbDNNRelease(packed_handle) |
修改后的 G06 也通过了编译和严格链接。原版首轮日志停在缺失头文件处;后续接口修改及其结果,分别保存在补丁和修复日志中。
至此,三个失败案例都取得了接口修复后的构建结果:G02 改一处枚举名,G03 改两处枚举名,G06 调整头文件和相关接口调用。原版三份通过与三个修复副本通过分别记录,便于看清问题来自哪里、修改影响了什么。
六、一个链接选项,怎样让缺失函数的代码也返回成功?
检查官方样例的 CMake 配置时,我注意到一个选项:
为了观察该选项的影响,我构造了下面这个小反例。它不依赖 UCP,只声明并调用一个没有实现的函数:
编译返回 0,宽松链接也返回 0;严格链接返回 1,并报告:
这里 0 表示命令报告成功,1 表示这次命令失败。函数实现始终没有提供,改变的是链接器处理缺失符号的策略。
我还让两个未修改的官方样例分别使用宽松与严格策略链接,两种情况下都通过。完整对照如下:
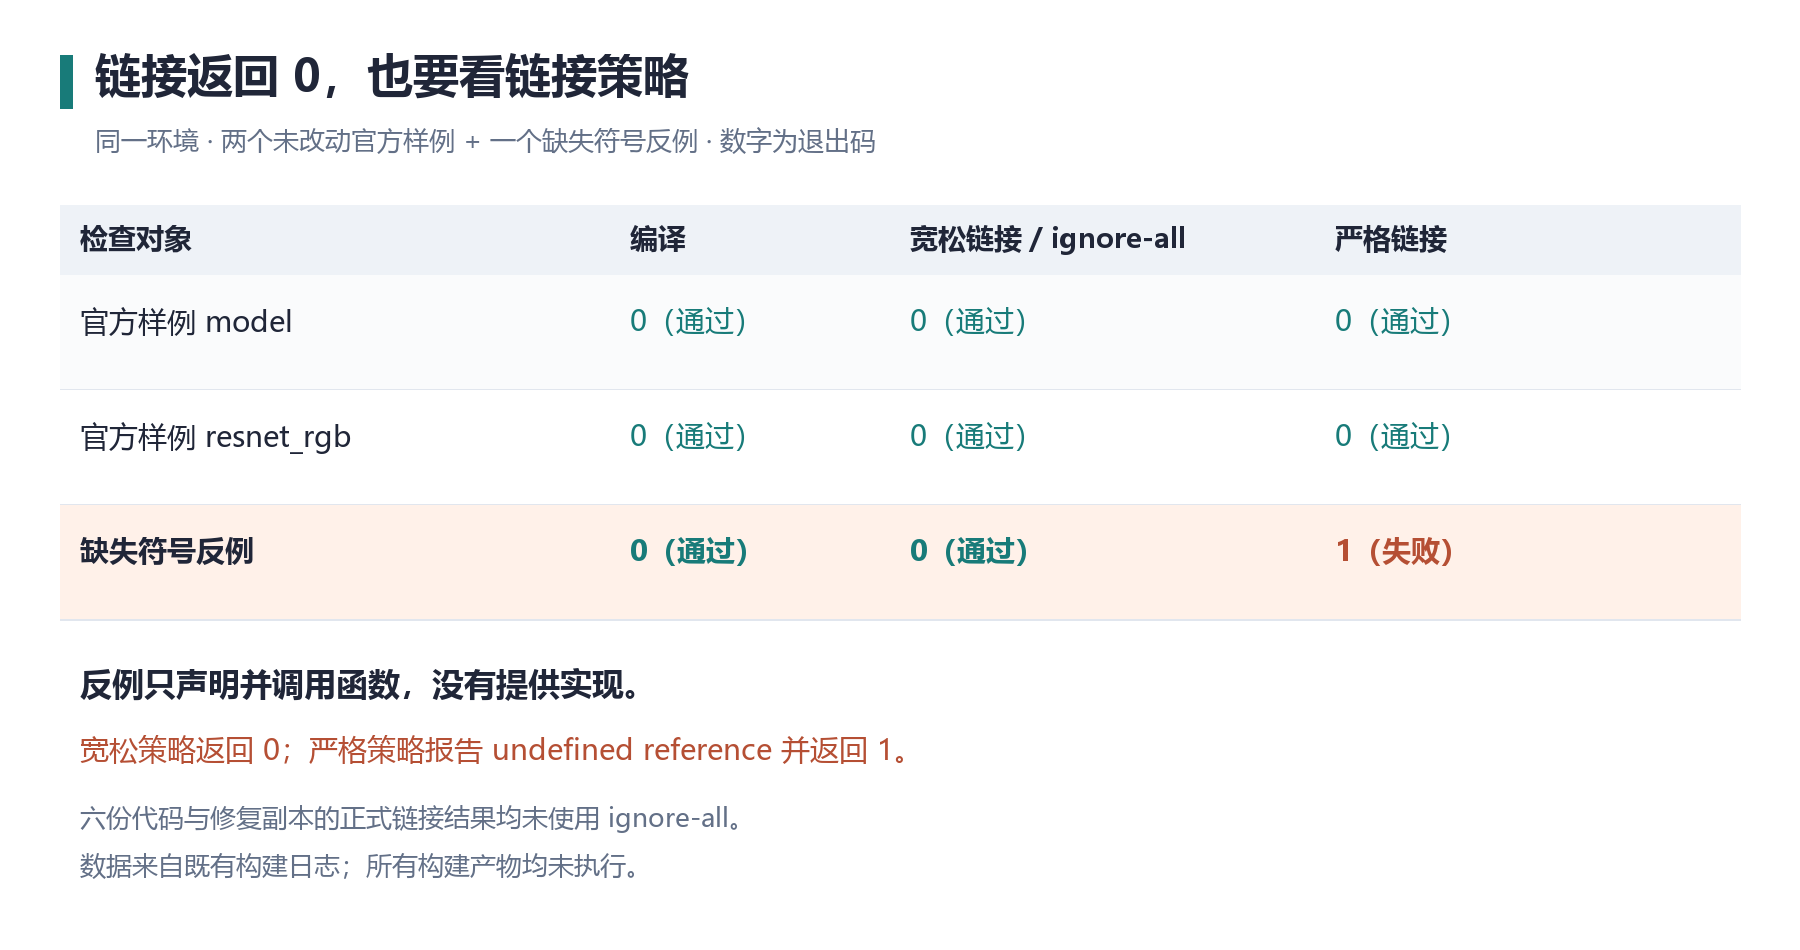
图2|同一环境下的编译与链接退出码。两个官方样例在两种策略下都通过;缺失符号反例只在严格策略下报错。所有产物均未执行。
七、通过构建的代码,仍有哪些问题留在源码里?
G05 就是一个很具体的例子。它负责错误处理和资源清理,在真实 SDK 下通过了编译和链接。可是沿源码检查,错误检查宏在失败时会跳到清理路径,局部错误码没有保存到最终返回值,函数末尾固定写着:
如果走到这些失败分支,函数清理完资源后,仍然会向调用者返回成功。保存错误状态,再在清理结束后返回,是这个函数需要另外解决的逻辑问题。
编译器接受它并不奇怪:这样的控制流在语法上成立,函数引用也能解析。构建工具检查了代码如何组成程序,而代码在出错时应当向上层报告什么,还需要沿控制流继续审查。
G03 的接口修复也没有处理全部逻辑。它的示例仍把普通 vector 地址和手填物理地址放进系统内存描述,再调用缓存维护接口;反量化函数也没有按张量 stride,也就是实际内存步长,定位元素。这些来自源码的风险没有被枚举名补丁消除。
所以我保留两类记录:编译与链接日志定位当前 SDK 下的名称、签名和符号问题;源码审查继续追踪数据布局、内存来源和失败路径。本次三个修复副本通过的是接口构建检查。
八、这次复验得到的结果
原版与修复版都在新的隔离容器和新输出目录中重复检查过。原版仍然是 G01、G04、G05 通过,G02、G03、G06 编译失败;三个修复副本仍全部编译、严格链接通过。输入文件未改动,逐例结果一致。每一步的参数、退出码、原始日志和补丁都保存下来,便于复查。
回到文章开头的问题:为什么旧检查通过的代码,换成真实 SDK 后会报错?G02 给出了具体答案——旧 stub 把一个并不存在于本次 SDK 的名称写进了头文件,检查因此放过了同样使用这个名字的代码。
这轮实验也把原来停在源码里的判断落实到了构建结果上:哪些原代码可以被当前 SDK 接受,哪些需要修改,修改后是否通过,以及链接选项怎样影响检查结论,都有对应记录。
参考资料
- 本次 SDK 依据:OE 3.9.1 随包 samples/ucp_tutorial/deps_x86/ucp/ 下的头文件、共享库,以及官方样例的 CMake 配置。