上一篇结束时,我知道了哪些代码能编译、哪些接口需要修改。但还有一件最直观的事没有做:给程序一张图片,让真实征程 6 开发板识别它,再把结果拿回来检查。
这次我在 Codex 的协助下,把最小推理示例接成了一个图片分类小工具。输入 JPEG,程序完成图片处理、板端推理和类别解码,最后输出 top-5、原始数据和一张标注图片。整个流程在申请到的 J6E 云板上执行。
最终,30 张 JPEG 全部完成了这条流程,送入模型的输入和取回的原始输出,都与事先保存的本地参考逐字节一致。这个结果回答了前面在本地准备的模型和数据,到了真实开发板上,是否还是同一套东西的问题。
一、要把哪条链路接起来?
图片文件不能直接交给这份模型。模型接收的是一个固定大小的数字数组,因此程序要先把图片处理成它要求的格式;模型返回的也是数字数组,还要按它实际提供的量化参数,转换成可以排序的分类分数。
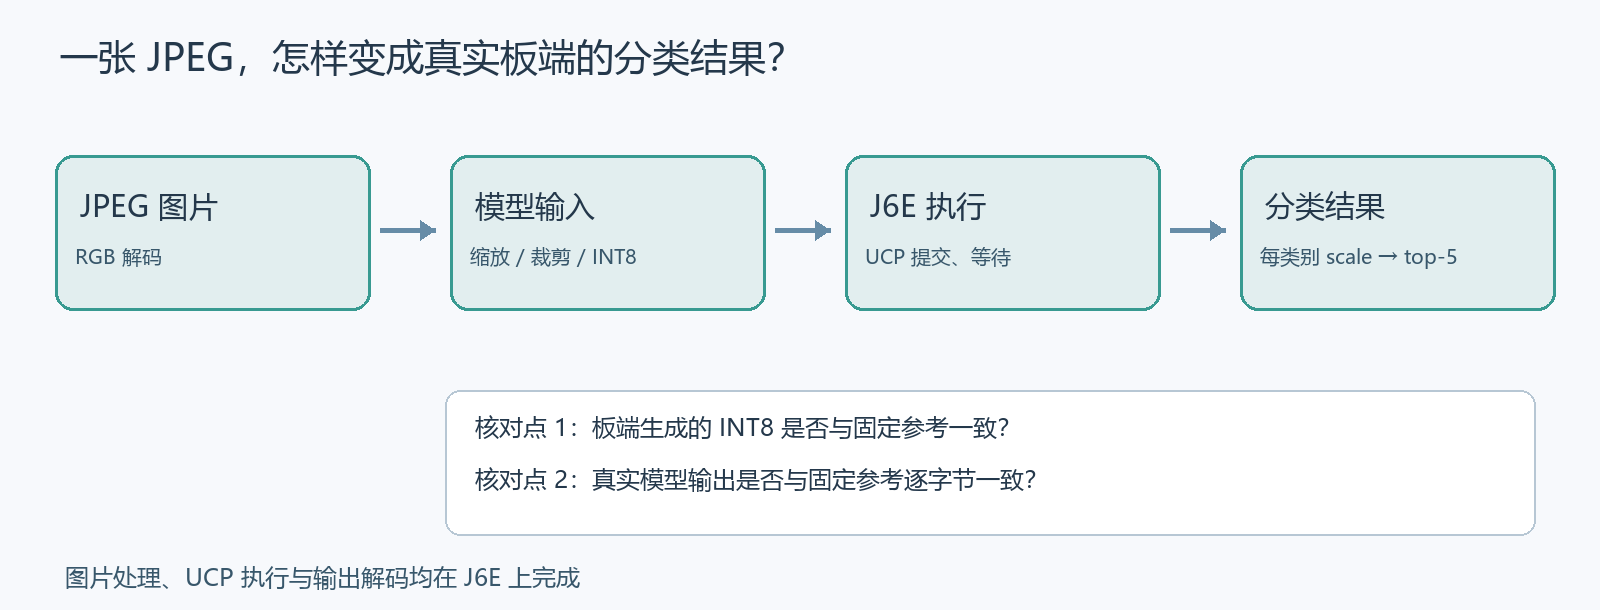
图1|图片处理和输出解码在板上完成,UCP 负责提交并等待模型任务。输入与原始输出另外保存,便于检查第一处差异。
我选用之前已经准备好的 ResNet18 分类模型。它的任务是从 ImageNet 的 1000 个类别中给图片排序,例如鸟、狗和汽车。这里先不更换模型,目的是把“本地准备—板端执行—结果核对”连起来。
本轮主要环境如下。
项目 | 实际设置 |
|---|---|
开发板 | J6E MatrixB,aarch64 |
系统 | Debian 12,GLIBC 2.36 |
SDK | OE 3.9.1 |
运行库 | UCP 3.15.8,HBRT 4.11.11 |
ARM 编译器 | 官方包内 GNU 12.2 工具链 |
分类输入 | INT8,[1,3,224,224] |
分类输出 | INT32,[1,1000],每类别 scale |
图片集合 | 已固定的 30 张诊断图片,与模型使用的 70 张校准图片分开 |
二、第一步就遇到了问题:程序能构建,模型却加载失败
连接开发板后,我先查看已有工具和运行库,再尝试加载同一份 HBM 模型。HBM 是地平线工具链编译后供运行库使用的模型文件。
我随后在自己的目录中准备了与 OE 3.9.1 对应的工具和库。相同模型用 UCP 3.15.8、HBRT 4.11.11 成功加载,官方工具也完成了推理。原有系统程序没有被覆盖。
前一篇验证了代码和真实头文件、库能否完成构建,上板后,还必须确认目标板上的运行库能够加载当前模型。本次就是在模型加载阶段遇到了版本配合问题。
为避免后面的结果依赖一份来历不明的可执行文件,我保留了官方工具的源码构建记录、编译器版本和运行库版本。自有程序也使用同一份 SDK 头文件和官方 ARM 工具链构建。
三、先核对固定输入,再接入 JPEG
如果直接把图片预处理、模型执行和输出解码一起接上,一旦结果不同,很难知道问题出在哪里。我先使用已经保存好的 INT8 输入文件,让板端程序只负责模型执行。
执行器完成以下步骤:
查询模型输入和输出属性,检查 dtype、shape、stride 和内存大小。
分配缓存内存,装入输入,并执行输入缓存清理。
创建、提交并等待 UCP 任务。
执行输出缓存失效处理,导出有效 INT32 元素和真实量化参数。
释放任务、内存和模型;失败时记录阶段并返回非零状态。
我先用官方工具执行同一份输入,再比较自有程序的原始输出。两条路径逐字节一致后,才扩展到完整输入集。
输入组 | 数量 | 板端与固定本地参考的 raw 输出 |
|---|---|---|
正常预处理输入 | 30 | 30/30 一致 |
受控错误输入 | 9 | 9/9 一致 |
恢复正确预处理的输入 | 3 | 3/3 一致 |
合计 | 42 | 42/42 一致 |
这里的“一致”是相同输入在本地参考执行和真实板端执行时,得到相同输出。九份故障输入是故意改变颜色或归一化规则的样本,它们不能算成九次正确识别。
另外,三个正常样例各补跑两次,原始输出保持一致。缺失输入、输入长度只有一个字节、缺失模型三种情况均返回非零状态;这些错误之后重新运行正常输入,输出仍与参考一致。
四、接上图片处理,让工具真正接收一张 JPEG
固定输入验证通过后,我把图片处理接到执行器前面。这份 ResNet18 的输入约定是:
30 张 JPEG 的图片处理都在开发板上执行。每张处理完,我先比较生成的 150528 字节 INT8 与冻结参考,随后执行 UCP,再比较返回的 4000 字节有效 INT32 输出。两次比较分别定位图片处理和模型执行。
结果是:30 份输入一致,30 份原始输出也一致。
五、模型给了 1000 个整数,怎样得到“这是一只鸟”?
这份模型的输出是量化后的 INT32,每个类别有自己的 scale。读取结果时,我使用实际 SDK 返回的 scale 和 zero-point 计算:
随后对这些分数排序,得到 top-5。结果 JSON 保存的是 logit 分数,没有把它们写成识别概率。
这个处理在前面的本地实验里已经验证过,这次我核对了真实板端的属性和输出。30 张正常图片中,有 9 张直接对原始 INT32 求最大值,会得到不同于正确解码的类别。运行没有报错,也不意味着可以省掉这一步。
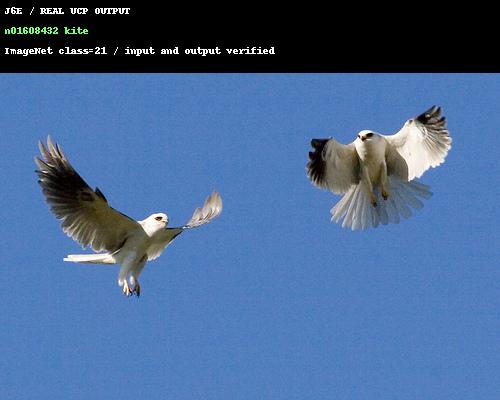
图2|输入是 JPEG,图片处理和模型执行都在 J6E 上完成。图中的类别来自按实际量化参数解码后的输出。
在这 30 张诊断图片上,按图片已有标签核对,top-1 为 24/30、top-5 为 28/30。这是该小样本的识别结果;本轮更主要的验收点,是图片处理和模型输出能否在本地、板端两条路径之间对应起来。
六、怎样换成自己的图片?
一次成功执行后,输出目录包含:
程序会检查模型哈希,并拒绝覆盖已有输出目录。这是对当前固定模型的图片入口;更换模型时,需要重新核对预处理与输出约定。
为了检查这个入口没有依赖实验中的参考答案,我又用它在板上执行了一张分类图片,并在程序外比较输入和 raw 输出,仍与基线一致。同一个工具包还提供检测入口,检测模型的 NV12 输入和后处理将在后续实验中展开。
七、这次补上了什么?
这之前,手里是能够构建的 C++。这之后,手里多了一个实际接收图片的程序:给它 JPEG,它会在真实 J6E 上执行模型,并留下可以查看、可以逐层核对的结果。
过程中真正起作用的,是先把运行库和模型加载配好,再用固定输入核对执行器,最后接入图片处理。哪一步出现差异,就能回到对应输入、原始输出和属性文件检查,而不用只盯着最终类别猜原因。
接下来要解决的应用问题也很明确:模型推理本身很快,但每张图片重新加载模型时,完整识别仍然很慢。我已经另外做了模型常驻对照,下一篇将按实际阶段耗时解释时间花在哪里、修改后又快在哪里。
参考资料
上一轮:《把六份 UCP 代码交给真实 SDK:一次编译与链接对照》。
- 本次接口与工具依据:OE 3.9.1 包内 samples/ucp_tutorial/、UCP 头文件、hrt_model_exec 源码及实际板端运行记录。