1. 为什么视觉 Token 值得重新挑选
一个语言模型读一张图,并不是把整张图当成一个词。图像通常先经过视觉编码器和投影模块,变成数百个视觉 Token,再与问题文本一同进入 LLM。分辨率提高、多图像或多帧视频会让这段序列更长,后续 Transformer 每层也要处理更多位置。
FastV 的出发点是:这些视觉位置并不都需要在 LLM 深层被同等保留。官方仓库通过 Attention 可视化观察视觉 Token 的利用情况,并尝试保留模型当时更关注的位置,减少后续层的工作。这是推理时、免额外训练的剪枝方法,不是把图像分辨率调低,也不是一个新视觉编码器。Attention 分数是选择位置的启发式信号,不是“此位置绝对无用”的证明。
FastV 的关键是在 LLM 内部选择:全部视觉 Token 先经过前 K 层,再决定后面的层保留哪些视觉位置。视觉编码器和早期层已经完成的计算不会因此消失。下图用 512 个视觉 Token、32 个文本 Token的教学例子说明这一位置关系,具体流程以 inplace 删除路径为例。
2. 参数 K 和 R 介绍
K:在何处剪枝。K 为剪枝起始层索引,前 K 层(索引 0 到 K-1)完整计算,在第 K 层执行剪枝。层索引从 0 开始,所以 K=2 表示前两层(索引 0、1)完整运行,第三层(索引 2)开始用缩短序列。
R:裁掉多少视觉 Token。在 HF 配置中,fastv_r 是删除比例,保留数量是 round(Nv × (1−R))。例如 Nv=512、R=0.75 保留 128 个视觉位置。下面以“32 层、K=2、视觉 512、文本 32、R=0.75”为例,示例不额外计入特殊 Token,实际总长度须以输入为准。
阶段 | 视觉位置 | 文本位置 | 该阶段总位置 S |
|---|
Vision Encoder 输出(仅视觉,不含文本) | 512 | 不适用 | 512 |
视觉与文本组合后的 LLM 输入、LLM 第 1~2 层 | 512 | 32 | 544 |
LLM 第 3~32 层 | 128 | 32 | 160 |
3. 如何评估视觉 Token 的重要性
FAST V 根据 Attention 分数筛选需要保留的视觉 Token。这里使用的不是所有 Query 的平均注意力,而是最后一个 Query 位置对各个视觉 Token 的注意力分数。
具体来说,源码对所有 Attention Head 的分数求平均,然后取第一个 Batch 中最后一个 Query 对应的注意力,最后只保留视觉 Token 所对应的分数。
可以把它理解为:观察序列最后一个位置更关注图像中的哪些 Token,并据此判断哪些视觉信息值得保留。
在首次 Prefill 阶段,最后一个 Query 通常对应输入 Prompt 的最后一个位置。它能够关注前面的图像和文本信息,但不一定对应问题中的某个关键词,也可能受到聊天模板结尾的影响。因此,这种方法是根据注意力分数筛选视觉 Token,而不是直接理解图像内容后给每个 Token 打分。
例如,图像包含 4 个视觉 Token,注意力分数分别为 [0.1, 0.8, 0.2, 0.7]。如果只保留一半,就选择分数最高的 v1 和 v3。
筛选时只对视觉 Token 进行 Top-K,文本 Token 不参与竞争,仍然全部保留。筛选完成后,再按照 Token 在原始序列中的顺序排列,因此后续模型接收到的是“原有文本 + 保留下来的视觉 Token”,而不是按照注意力分数重新排列的序列。
4. 删除视觉 Token 后位置处理方式
删除视觉 Token 后,序列长度缩短了,但保留下来的 Token 仍然需要对应正确的原始位置信息。
例如,原始序列的位置编号为 [0, 1, 2, 3, 4, 5, 6, 7],删除其中的部分视觉 Token 后,保留的位置可能是 [0, 1, 3, 5, 6, 7]。
这里需要区分两件事:
这样可以避免将原始位置关系错误地改写。对于使用 RoPE 的模型,位置编号会影响位置编码计算。
此外,源码还可能需要同步调整 cache_position 和 causal mask:前者涉及缓存位置管理,后者需要适配缩短后的序列。它们与 position_ids 的用途不同,不能简单地视为同一组位置编号。
5. 带缓存时fastv实现方式
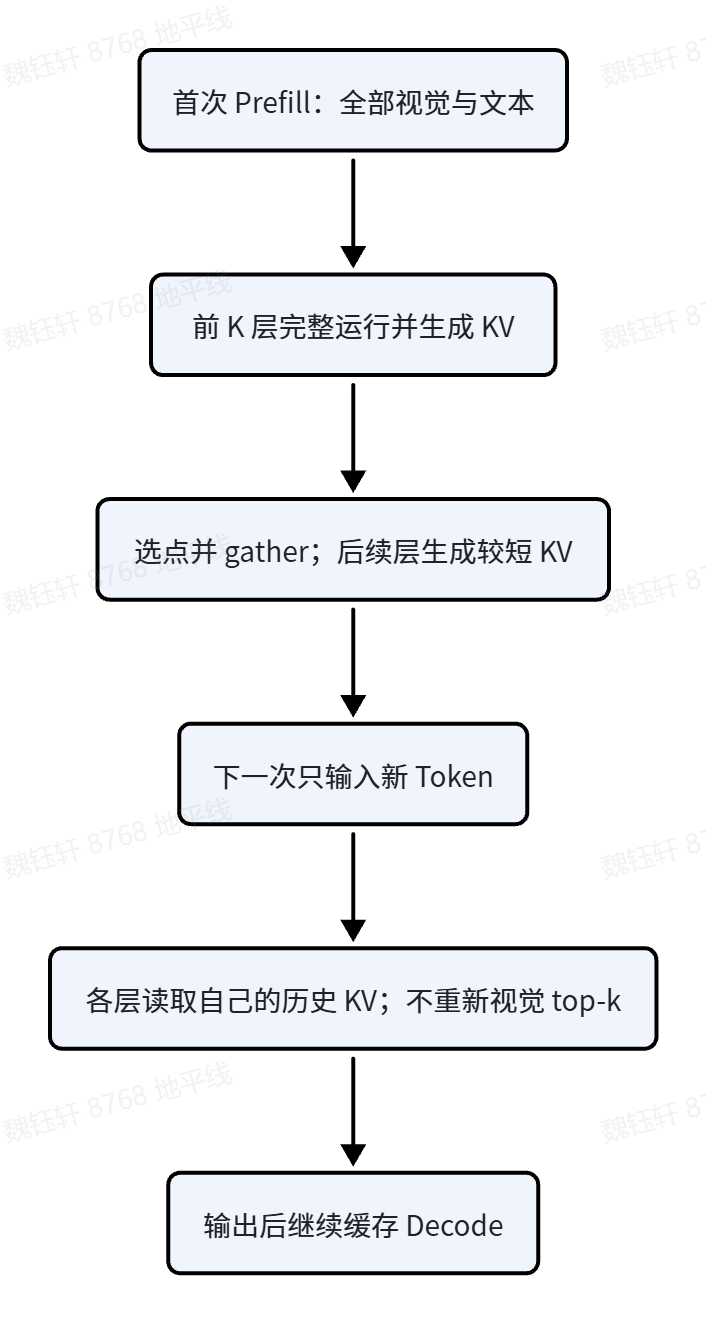
HF 的 fastv_forward 在 use_cache=True 且输入长度不为 1 时执行初始剪枝;当后续输入只剩一个新 Token,就跳过 top-k。缓存中的视觉集合因此沿用首轮选择,不会每步重新算一套完整视觉 Attention 来更新集合。
前 K 层已经写入完整长度,后续层才用缩短后的序列。HF 所配的 DynamicCache 按层保存 key_cache[layer_idx] 与 value_cache[layer_idx],每层在自己的历史 KV 后追加新位置;不同层缓存长度因此可以不同。
对应“32 层、前 2 层长度 544、后 30 层长度 160”的算例,如果每层 KV Head、Head 维度和精度相同,首轮逻辑 KV 元素数比例为 (2×544 + 30×160)/(32×544) ≈ 33.8%,而不是所有层一起缩短得到的 29.4%。这只估算各层缓存元素数,不包含后续生成 Token、物理对齐与额外内存开销,也不是整个进程显存的缩减比例。
6. 剪掉 Token 的代价与模型适配边界
视觉编码和 LLM 早期层的 Attention 已让保留下来的 hidden state 融合一部分上下文,所以删去深层视觉位置不等于只留下几个未经处理的原始 Patch。不过,先前的信息融合并不保证细节全部保住:OCR、细粒度属性、小目标、罕见场景或视频中的短暂事件,都可能受影响。
可视化问题、整张图问答和驾驶动作任务需要的信息不同。迁移到多摄像头 VLM/VLA 时,先核对 Token 排布、评分 Query、每幅图/每帧预算以及位置编码,再测小目标和安全关键场景。能加载运行、单张示例回答一致,不足以证明任务精度无损。
对标准全注意力,某一层从 544 个位置缩到 160 个位置,线性相关工作长度比例为 160/544 ≈ 29.4%,逻辑 Q–K 配对比例为 (160/544)² ≈ 8.65%。二者作用于不同算子,早期 K 层和视觉编码器仍保留原开销,还要加上评分、top-k、索引重排,因此不能只拿某个比例当作整体加速倍数。
7. 总结
FastV 先让模型用早期层“看一遍”完整视觉上下文,再用最后 Query 的 Attention 排名,在指定层之后只继续处理部分视觉位置;它能否真正加速,取决于使用 Mask、实际 Token Drop 还是缓存版本,以及目标任务是否容忍剪枝带来的信息损失。
8. 参考
源码:https://github.com/pkunlp-icler/FastV