前面的部署实践已经把 YOLOv5x 编译为 HBM,并完成了板端推理。这次换一个观察角度:直接对同一份 HBM 运行 hb_analyzer,查看模型级性能、内存与算子热点,再对比开发机静态预估和 J6E 板端采集结果。
hb_analyzer analyze 支持直接分析 HBM;不指定 --ip 时生成静态预估,指定板卡 IP 时采集板端性能。工具还提供 visualize 子命令,但本文只使用 analyze。
1. 实验对象与环境
项目 | 本次配置 |
|---|
模型 | yolov5x_640x640_nv12.hbm |
OpenExplorer 发布包 | horizon_j6_open_explorer_v3.8.1-py310_20260326 |
horizon_tc_ui | 3.5.11 |
HBDK 编译与分析版本 | 4.9.7 |
板卡 | Horizon Robotics J6E MatrixB Development Board |
BPU 架构与核心数 | nash-e,1 核 |
HBM 是前文编译产生的模型,输入为 NV12 的 Y、UV 两个平面,输出为 YOLOv5x 的三个检测头。这里不重新编译模型,避免编译配置变化影响对比。
2. 两种分析模式怎么运行
以下展示本次实验使用的模型和输出目录。直接重复执行会覆盖现有报告。这里使用 HBM 文件的绝对路径,是因为命令会切换工作目录。
不传 --ip,hb_analyzer 在开发机侧生成静态预估:
传入板卡 IP 后,工具远程连接板卡执行模型并取回性能数据。本次目标板通过 /proc/device-tree/model 确认为 J6E MatrixB;
每个目录包含 hb_analyzer_report.html、.hb_analyzer/analysis_summary.json、.hb_analyzer/yolov5x_640x640_nv12.json 和 hb_analyzer.log。前者是本文主要阅读的交互式报告;analysis_summary.json 便于核对表格中的数字;per-graph JSON 则保存底层性能数据。
从 JSON 提取概览指标时,注意 hbm_key_indicators 是由 {title, value, unit} 组成的列表:
4. Overview:先确认整图指标
打开两份 hb_analyzer_report.html,先看首页的 Overview。页面顶部的 Key Indicators 汇总了模型计算量、延时、带宽和内存。以下数字来自本次重新生成的两份报告,而非编译目录中的旧报告。
指标 | 静态预估 | J6E 板端采集 |
|---|
Latency | 13.54 ms | 9.99 ms |
FPS | 73.88 | 100.09 |
单次 DDR 访问量 | 184,934,400 B | 184,934,400 B |
满帧率平均带宽(工具显示值) | 12.72 GB/s | 17.24 GB/s |
计算量 | 221.18 Gops | 221.18 Gops |
CPU 算子数 | 0 | 0 |
模型最小内存需求 | 117.88 MB | 117.88 MB |
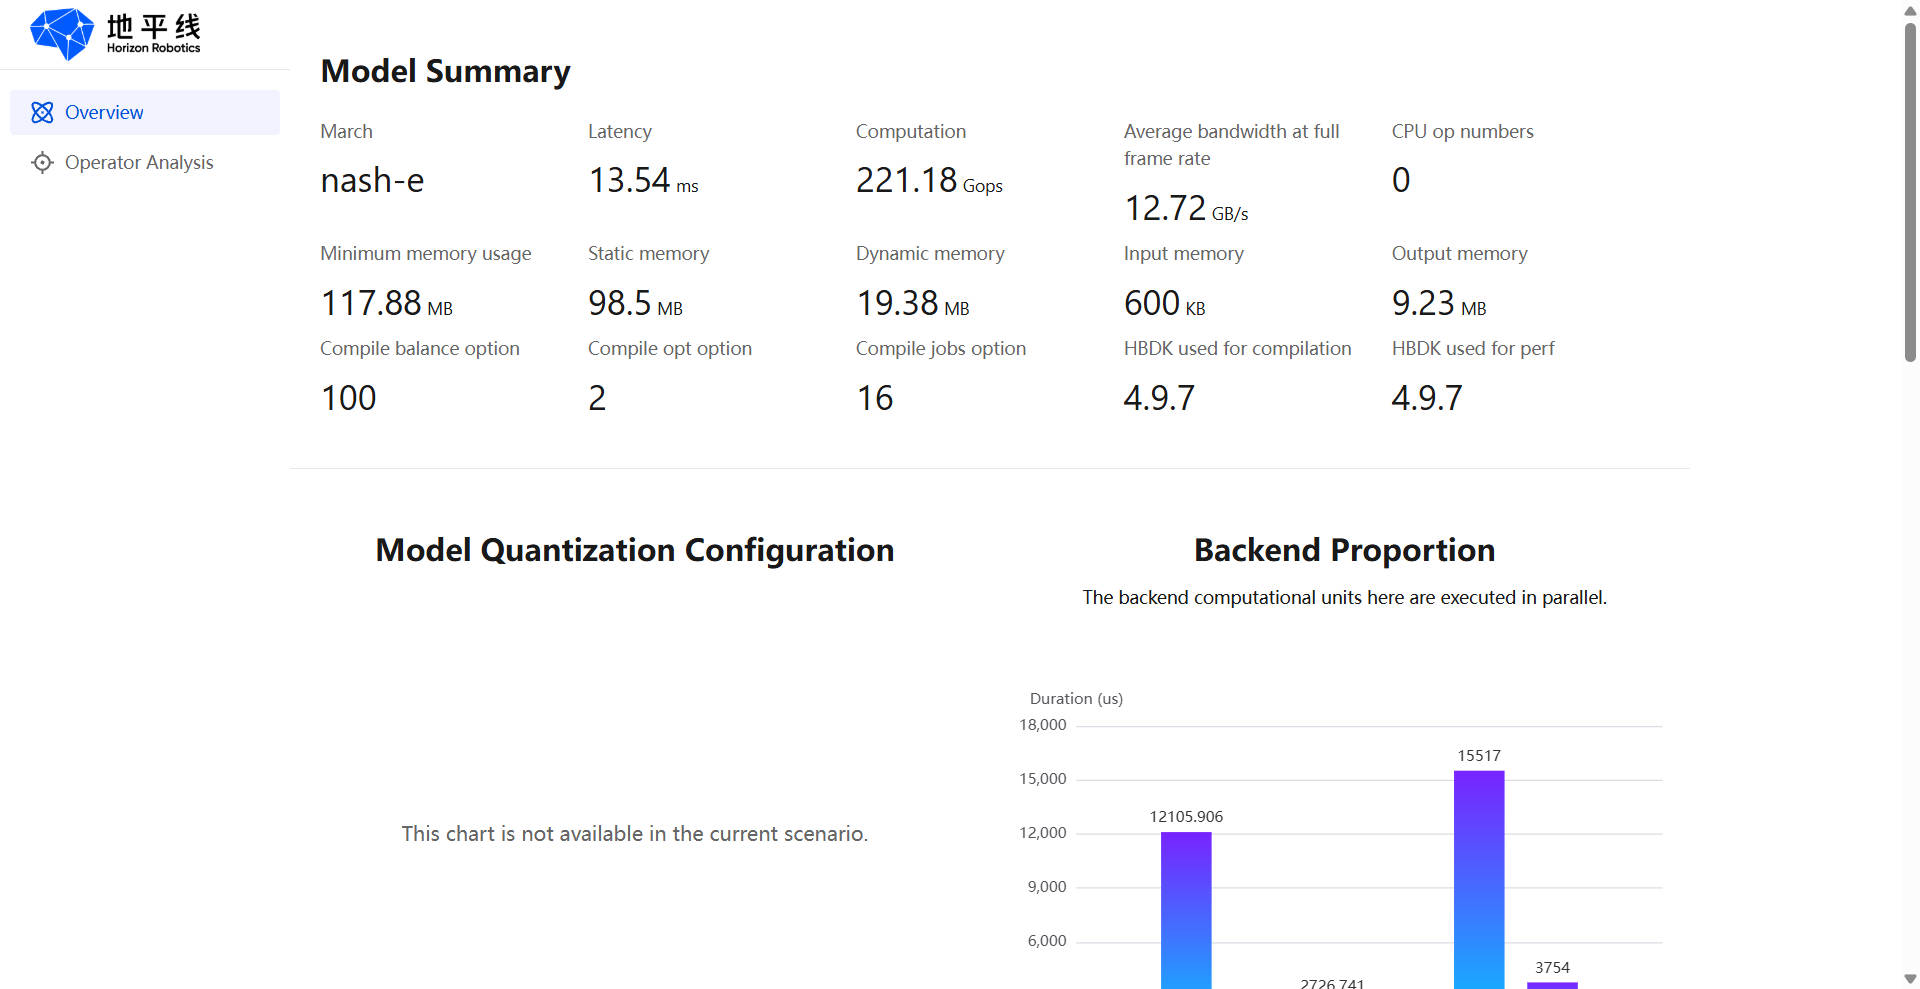
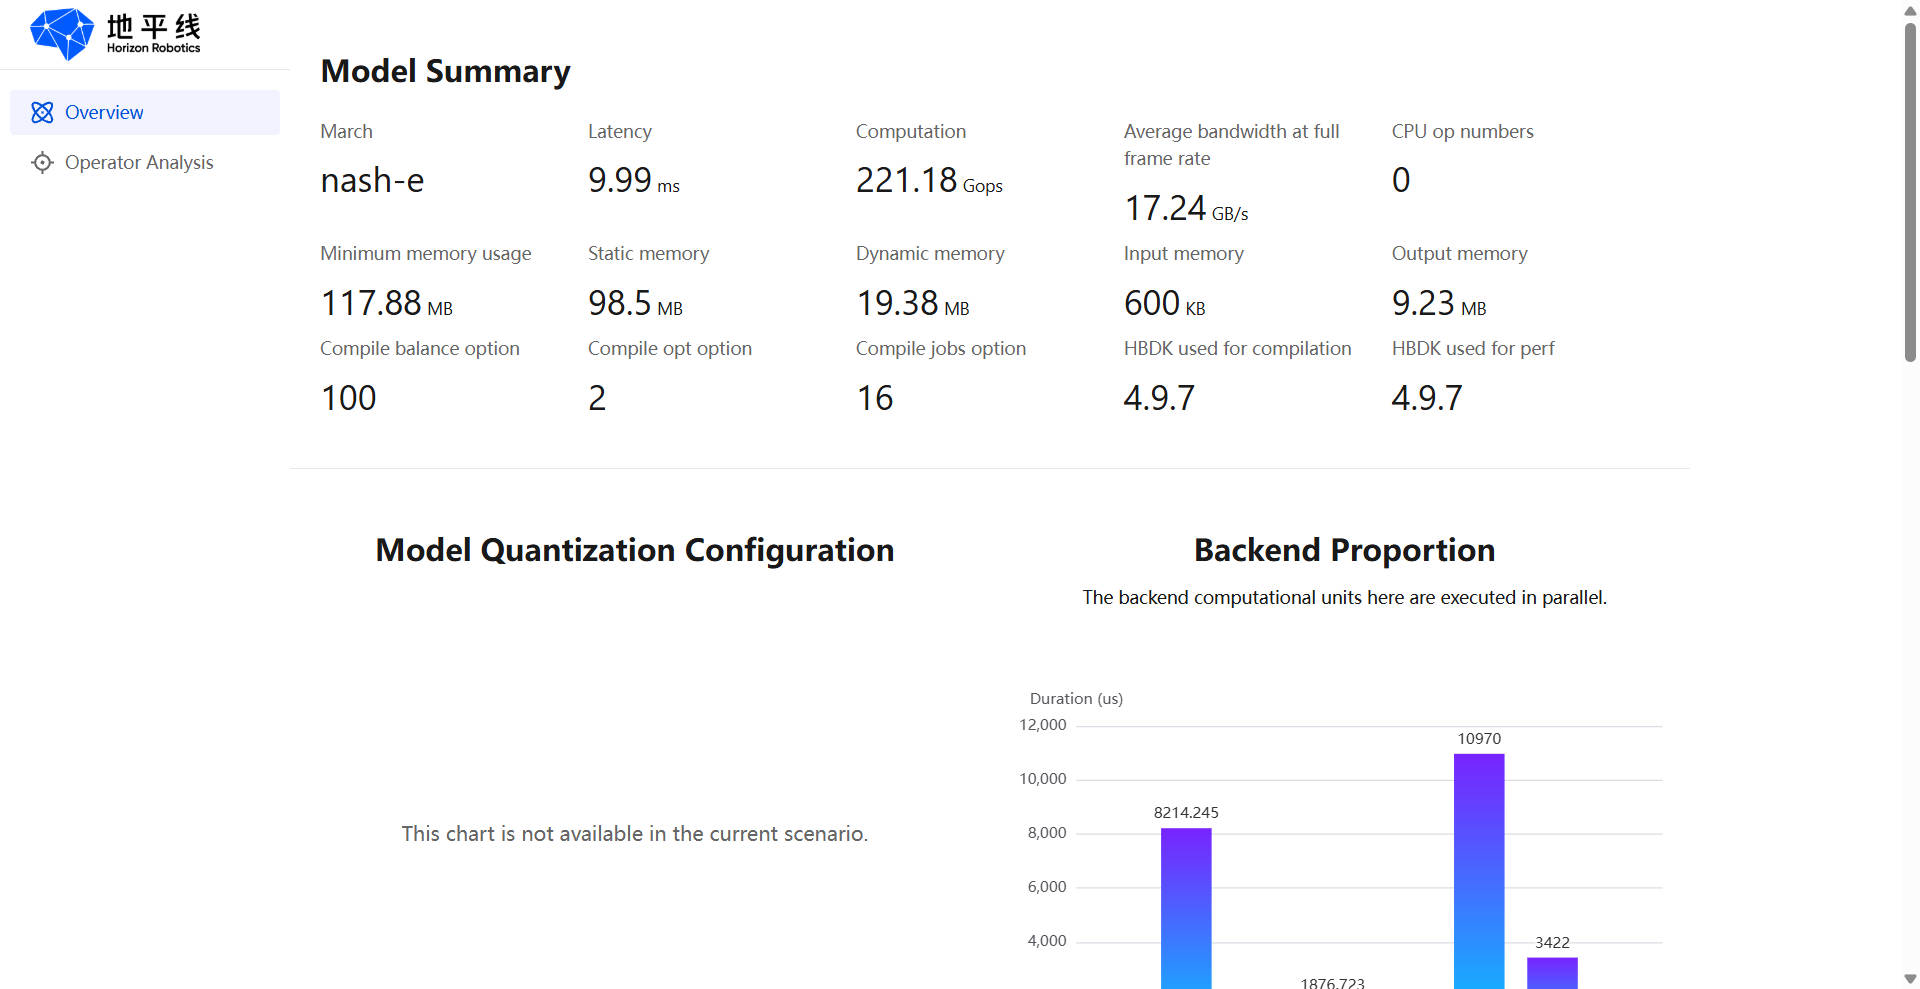
静态预估比这次板端采集高 3.55 ms,差值约为静态预估的 26.2%。这只说明两种分析模式在本次实验中的输出不同;官方文档同样将开发机预估和板端性能评估区分为不同路径。
模型性能评估说明为什么板端带宽数值更高
两份报告的“单次 DDR 访问量”相同,都是 184,934,400 B,约 176.37 MiB。Average bandwidth at full frame rate 则按各自模式下的满帧率计算。板端报告的 FPS 更高,因此带宽显示值也更高。
后面的 Operator Analysis 页面可以输入业务设计帧率,按单帧 DDR 数据量计算更贴近目标运行速率的带宽估算。
工具手册内存和 CPU 算子该怎么读
报告给出的最小内存需求为 117.88 MB,其中 Static memory 为 98.50 MB,Dynamic memory 为 19.38 MB。这个数字描述模型运行所需的内存,不代表整套业务程序的内存占用。
CPU 算子数为 0,说明这份 HBM 的分析报告没有记录 CPU 算子。图片读取、NV12 预处理、YOLOv5 解码和 NMS 仍由业务程序处理,不能用“CPU 算子数为 0”推断应用侧没有 CPU 工作。
Backend Proportion 与 TAE 空闲
Overview 中的 Backend Proportion 展示不同后端计算单元的耗时分布。板端报告显示 TAE 为 82.214%、VAE 为 18.784%、VPU 为 3.362%、TRANS 为 5.945%。这些比例之和超过 100%,因为计算单元可以并行工作;不能把它们当作互斥的“BPU 利用率”分项直接相加。
官方 Overview 说明同一份摘要里的 TAE idle analysis 没有给出空闲告警(warning_count=0、gaps=[])。这只表示报告没有标出符合其判定条件的空闲段,不能据此断定板卡始终满载。

5. Overview:用两个 Top Layers 表定位候选热点
板端报告的 Top Layers by Total Time 前三项如下:
算子 | 报告中的总耗时 |
|---|
/model.7/conv/Conv_id_865 | 553 µs |
/model.24/Reshape_id_1628 | 497 µs |
/model.21/conv/Conv_id_1483 | 344 µs |
Top Layers by IO Time 从访存角度给出了另一份排名。板端报告的前三项是:
节点 | IO 耗时 |
|---|
unamed_func.return_id_1649 | 256 µs |
/model.24/Reshape_id_1628 | 195 µs |
/model.7/conv/Conv_id_865 | 183 µs |
/model.24/Reshape_id_1628 同时出现在总耗时和 IO 耗时列表的靠前位置,值得在优化实验中继续检查其数据布局。不过,Top 列表只能定位观察对象,不能仅凭排名断言修改这个节点一定能降低整图延时。
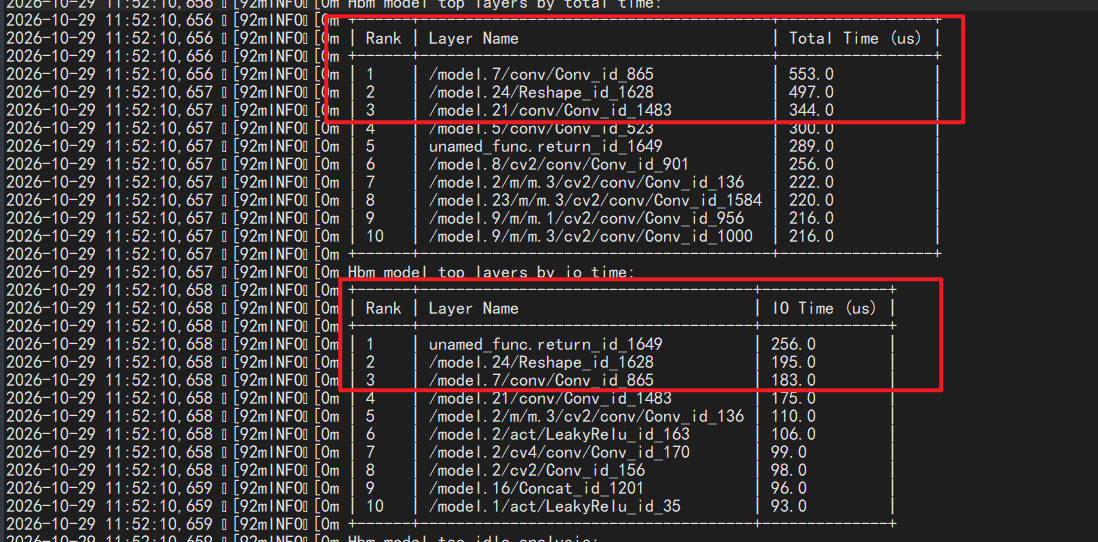
实际阅读 Overview 时,可以按“Key Indicators → Backend Proportion → 两份 Top Layers 表格”的顺序走。前一步给出整图范围,后两步提供继续调查的候选节点。
6. Operator Details:先辨认哪些数据可用
官方手册介绍的
Operator Details 用于对照浮点模型与定点模型的算子结构。此次只向 hb_analyzer 提供了 HBM;在生成的 analysis_summary.json 中,bc_float_model_statistics 和 bc_quantized_model_statistics 均为 null。本文没有浮点与定点算子对照数据,因此不从这一页推断量化前后的结构变化。
Operator Details 说明7. Operator Analysis:算子耗时与设计帧率
Operator Analysis 能按算子类型拆分 Total、Compute、Load、Store 时间。板端报告给出的分类结果是:
算子类型 | 数量 | Total | Compute | Load | Store |
|---|
Conv | 142 | 11.227 ms | 8.267 ms | 2.908 ms | 0.052 ms |
others | 32 | 1.878 ms | 1.148 ms | 0.304 ms | 0.426 ms |
LeakyRelu | 135 | 1.865 ms | 1.105 ms | 0.145 ms | 0.615 ms |
Add | 28 | 0.515 ms | 0.450 ms | 0.065 ms | 0 ms |
Conv 的分类 Total 为 11.227 ms,已经超过整图的 9.99 ms。这里汇总了 142 个卷积节点各自的时间,节点执行存在重叠;不能把各类型 Total 简单相加。这张表适合先判断哪些类型值得查,再返回 Top Layers 列表定位具体节点。
Operator Analysis 还有 Designed FPS 输入框,可按目标帧率查看带宽需求。两份报告的单次 DDR 访问量均为 184,934,400 B,约 176.37 MiB;Overview 中的满帧率带宽分别为 12.72 和 17.24 GB/s,差异来自两种模式各自的满帧率,并非同一帧搬运量不同。
例如把 Designed FPS 设为 10,仅按此次单帧 DDR 数据量估算,模型平均数据流量约为 184934400 × 10 / 2^30 ≈ 1.72 GiB/s。报告沿用工具页面的 GB/s 标签,此处用 GiB/s 明确表示按 2^30 字节换算。这个示例只覆盖报告统计的模型数据流量,不包含摄像头、CPU 后处理和其他模块。10 FPS 是演示值,并非本项目已经确定的业务目标帧率。
Operator Analysis 说明
8. 板端数字的适用边界
本次 hb_analyzer analyze --model ... --ip ... 成功将 HBM 和测试输入上传到板端 /tmp/remote_bpu,执行后取回性能数据。检查本次安装的 HBDK 4.9.7 实现可知,CLI 没有传入业务图片时会自动生成输入;这份定长 U8 NV12 模型落入 np.random.rand(...).astype(np.uint8) 路径,生成的 Y、UV 数值均为 0。
因此,9.99 ms 是工具自动生成输入条件下的板端模型性能。真实图片可能改变访存与压缩行为;完整应用还包括图像处理、推理提交、输出拷贝和后处理。本次实验没有测量真实图片端到端延时,也没有对不同输入内容或板端负载做多轮统计。
9. 小结
这次从同一份 HBM 得到了两份可追溯的 hb_analyzer_report.html:静态预估延时为 13.54 ms,J6E 板端工具采集值为 9.99 ms。Overview 适合核对整体指标与候选热点;Operator Analysis 适合结合设计帧率、算子类型和 Load/Store 拆分继续追查。Operator Details 在此次 HBM-only 输入下没有可解读的浮点/定点对照数据。
报告能帮助缩小下一步调查范围。评估真实业务帧率,还需在实际图片与完整应用链路下单独计时。


