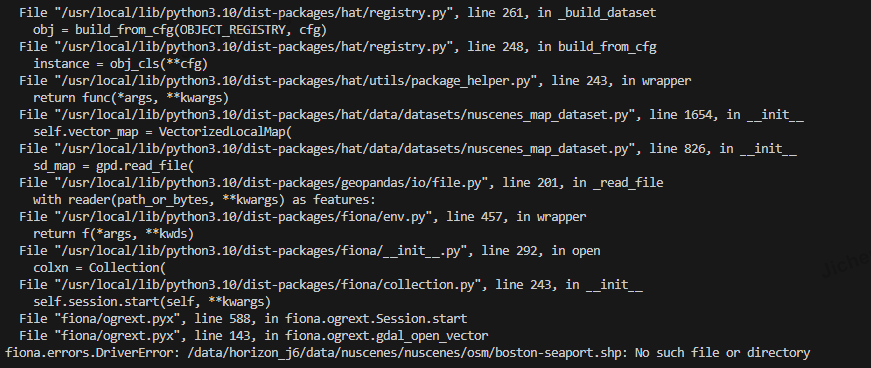
回到地平线官方示例包的文档页面(如 AI Benchmark)。找到 Nuscenes BEV/MapTR相关模型的“数据准备”章节。.严格按照文档要求的目录结构放置数据,并运行指定的 bpu_val_preprocess.py脚本进行预处理,而不是直接启动训练/评估导致底层SDK去读原始文件出错。

 Lv.5