目前安装了gpu版的oe-docker,想问一下PTQ量化过程中能否使用gpu加速,没有找到相关文档说明。
论坛算法工具链PTQ过程能否通过GPU来加速
PTQ过程能否通过GPU来加速
fataJtz2026-08-24
185
7
算法工具链
技术深度解析征程6
评论4
0/600
- 费小财
 Lv.5PTQ中的“校准”步骤如果是通过PyTorch插件执行,完全可以使用GPU加速;如果是通过hb_compile处理ONNX,则主要依赖CPU。建议优先采用PyTorch链路以充分利用GPU资源2026-09-0100
- 费小财Lv.5
- 加速方式:
- 确保你的 PyTorch 环境已正确安装 CUDA 版本的地平线插件(horizon_plugin_pytorch)。
- 在校准脚本中,将模型和数据移动到 GPU 上(例如使用 .cuda() 或 .to('cuda'))。
GPU 并行计算能力远高于 CPU,能显著缩短校准时间,尤其是对于大型模型或大量校准数据。
- 参考依据:参考信息中提到 OE-v3.5.0 适配支持 torch2.6/cuda12.6,且 PTQ 定义为“Pytorch模型基于 horizon_pytorch_plugin 进行 calibration 的模型校准阶段”。既然支持 CUDA 版本的 PyTorch,自然可以利用 GPU 进行前向传播加速
2026-09-0100 - DR_KANLv.5
J3 J5没办法,J6可以,gpu docker是自动应用gpu做加速校准的
2026-09-1100 - 金属货机Lv.2
在模型校准的时候会使用GPU来进行加速,但是图优化和编译是在CPU上进行的
2026-08-2403 fataJtz回复金属货机:请问如何判断在校准过程中使用了gpu加速,如下是我的部分量化日志
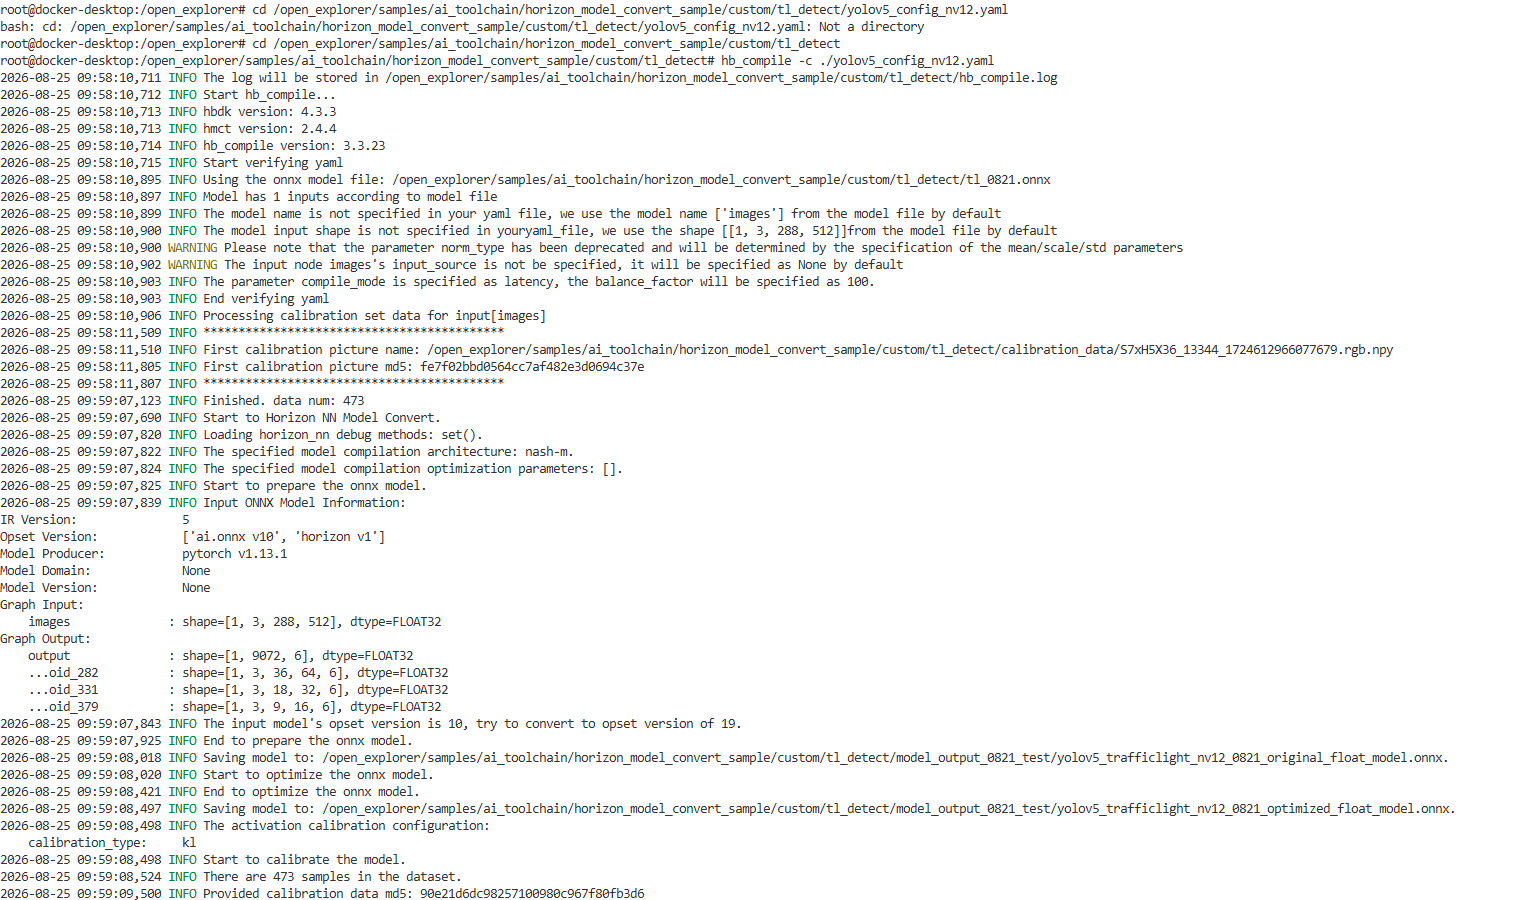
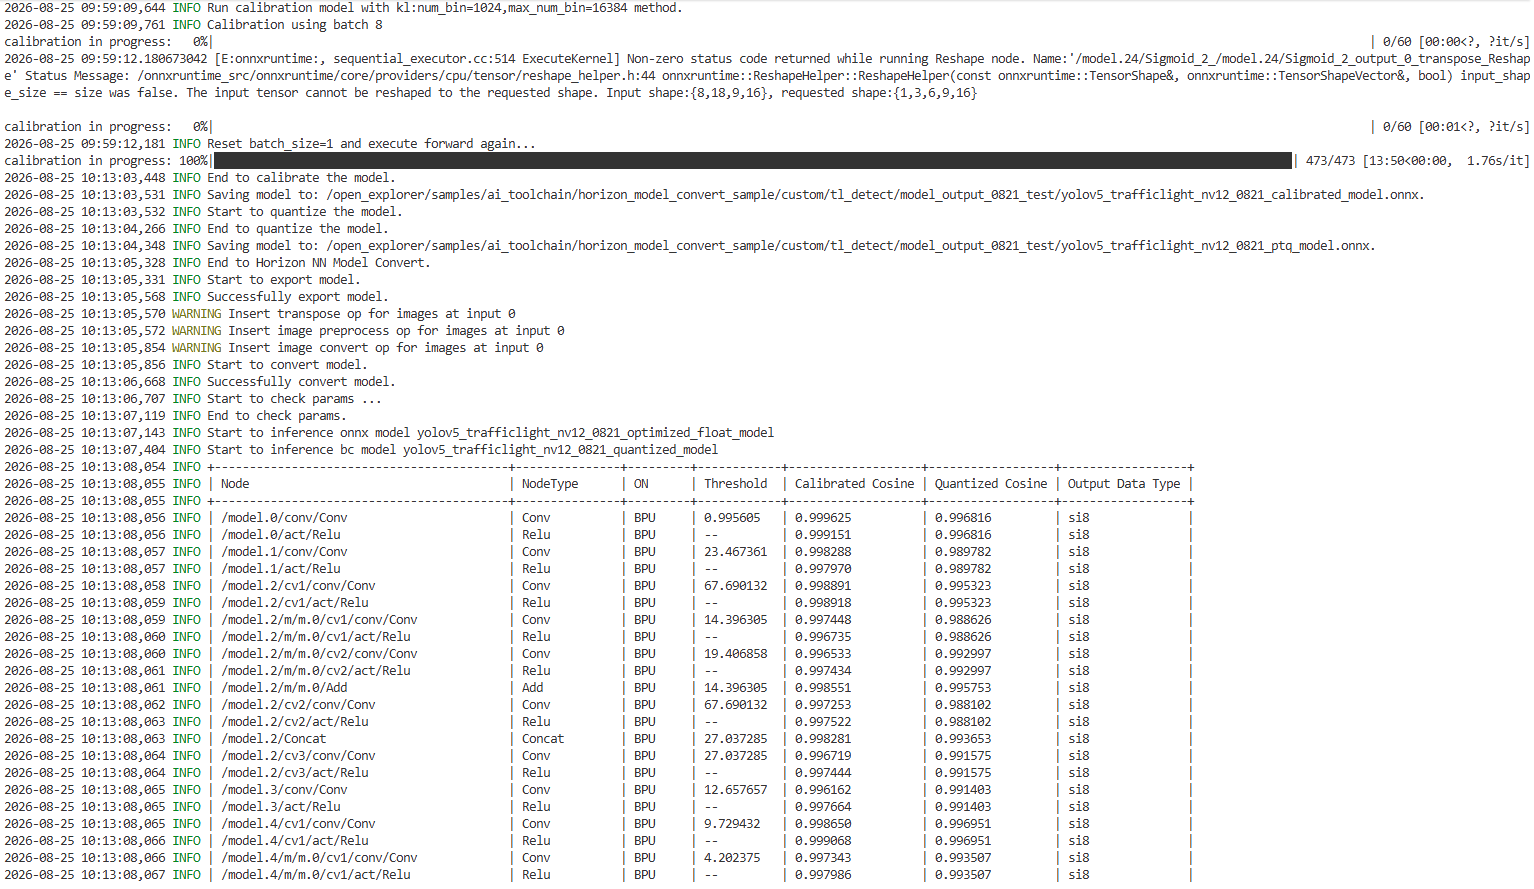 2026-08-250
- 金属货机回复fataJtz:
首先确保当前docker环境使用的是GPU版的onnxruntime,通过ort.get_available_providers()来看是否有CUDAExecutionProvider。之后在进行量化的时候可以新开一个终端去watch - n 1 nvidia-smi,进入到calibration的时候GPU是参与了运算的。
2026-08-250 - 费小财回复fataJtz:无法通过日志判断“校准是否使用了 GPU”,因为正常情况下它就不会使用。您看到的 VLM analysis timed out 和 Reshape 错误与 GPU 加速无关,而是模型结构兼容性和编译器超时的问题2026-09-130