测试环境与模型基线
UCP 4.14.7
hbdk: 4.9.7
model:fcos_efficientnetb0_512x512_nv12
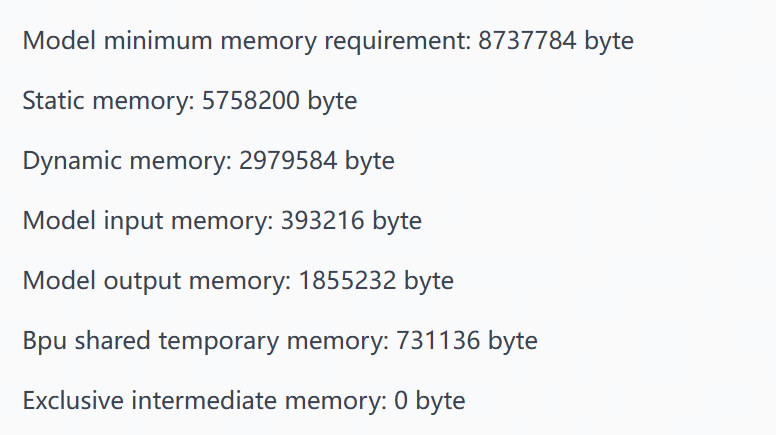
hbdk: 4.9.7
model:fcos_efficientnetb0_512x512_nv12
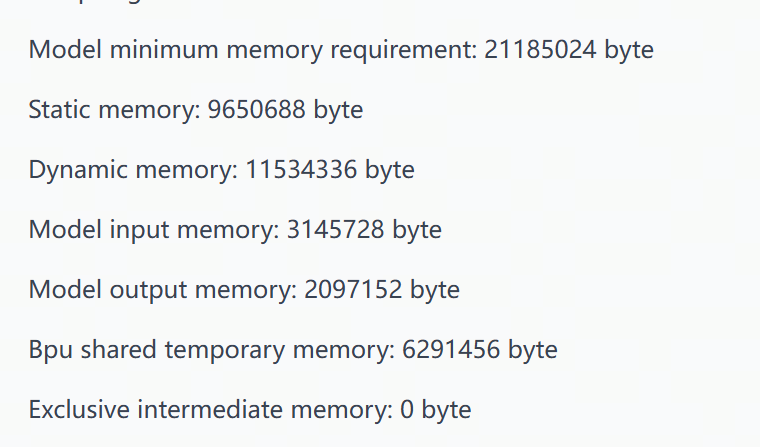
model:deeplabv3plus_efficientnetm2_1024x2048_nv12
基础概念
VmRSS(Virual Memory Resident Set Size):进程当前实际驻留在物理内存中的大小,单位KB,表示这个进程吃了多少物理内存,一般系统稳态后这个值不会发生变化,简单观测这个值也可以用于判断是否内存泄漏
VmSize(Virtual Memory Size):虚拟内存的总量,表示当前进程/线程申请了多少地址空间,包含大量未实际使用的mmap区域
VmHWM(Virtual Memory High Water Mark):进程自启动依赖实际占用的物理内存最高值,单位KB,由内核维护
VmPeak(Virtual Memory Peak):进程自启动依赖虚拟内存地址空间的最大值,包含所有mmap区域,未提交页和只读映射,数值常比物理占用虚高数倍
虚拟内存:虚拟内存是操作系统内核为了对进程地址空间进行管理而精心设计的一个逻辑意义上的内存空间概念。我们程序中的指针其实都是这个虚拟内存空间中的地址。比如我们在写完一段程序之后进行编译,这时候编译器采用的地址其实就是虚拟内存空间的地址,凡是程序运行过程中可能需要用到的指令或者数据都必须在虚拟内存空间中。
驻留内存:顾名思义驻留内存是指那些被映射到进程虚拟内存空间的物理内存。进程的驻留内存就说进程实实在在占用的物理内存,一般我们所讲的进程占用了多少内存,其实就是说的占用了多少驻留内存
共享内存:我们的程序在运行时会依赖于很多外部的动态库,这些动态库在内存中仅仅会保存/映射一份,如果某个进程运行时需要这个动态库,那么动态加载器会讲这块内存映射到对应进程的虚拟空间中。多个进程之间通过共享内存的方式相互通信也会出现这样的情况。
驻留内存:顾名思义驻留内存是指那些被映射到进程虚拟内存空间的物理内存。进程的驻留内存就说进程实实在在占用的物理内存,一般我们所讲的进程占用了多少内存,其实就是说的占用了多少驻留内存
共享内存:我们的程序在运行时会依赖于很多外部的动态库,这些动态库在内存中仅仅会保存/映射一份,如果某个进程运行时需要这个动态库,那么动态加载器会讲这块内存映射到对应进程的虚拟空间中。多个进程之间通过共享内存的方式相互通信也会出现这样的情况。
模型申请内存大小
以fcos_efficientnetb0_512x512_nv12为例进行说明:
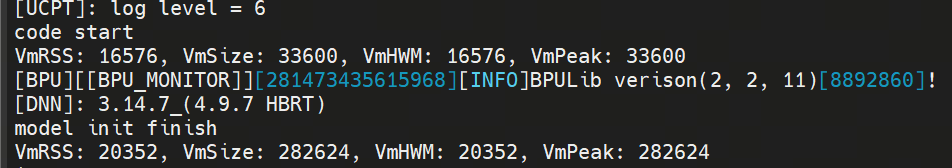
VmSize = 282624 - 33600 = 249024KB
Static memory: 5758200 Byte
Bpu shared temporary memory: 731136 Byte
Exclusive intermediate memory: 0 Byte
VmSize = 282624 - 33600 = 249024KB
Static memory: 5758200 Byte
Bpu shared temporary memory: 731136 Byte
Exclusive intermediate memory: 0 Byte
由于模型首次加载时,需要将依赖的动态库等都加载进内存空间中,所以模型首次加载所需的虚拟内存的大于静态perf的内存,在后续模型加载时,动态库等依赖已经加载完毕,其内存变化就会和静态perf的一致了,模型实际申请的内存大小以静态perf为准。
输入输出申请后内存变化
结论
hbUCPMalloc接口申请的内存遵循64KB对齐原则,物理指针和虚拟指针也是65536字节对齐
说明
- 内存地址对齐原则
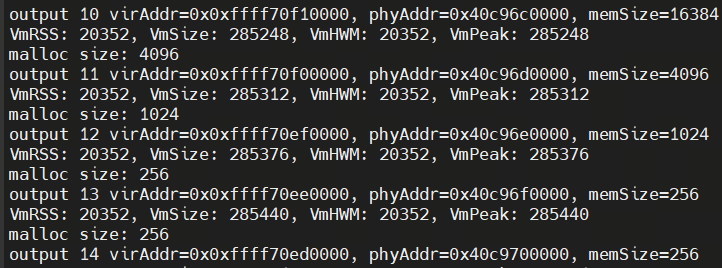
- 内存大小说明
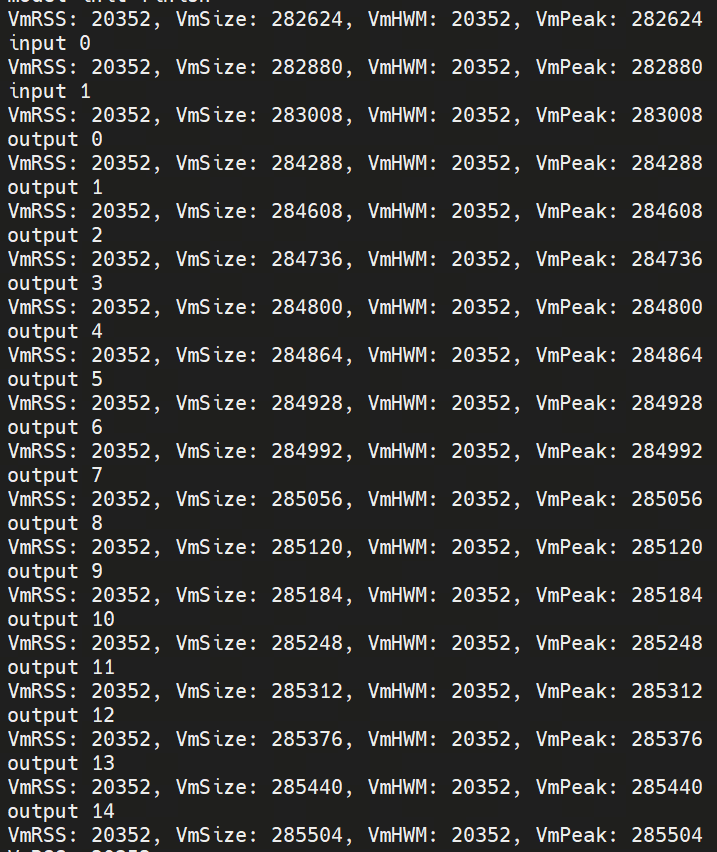
输入使用内存:393216 Byte = 384KB
输入shape:512x512,256x256x2
J6P:
input0: VmSize: 282880- 282624 = 256KB = 512x512/1024
input1: VmSize: 283008- 282880= 128KB = 256x256x2/1024
输出使用内存:1855232 Byte = 1811.75KB
output0: VmSize: 284288 - 283008 = 1280KB = 1310720/1024
output1: VmSize: 284608 - 284288 = 320KB = 327680/1024
output2: VmSize: 284736 - 284608 = 128KB 81920/1024=80KB
output3: VmSize: 284800 - 284736 = 64KB 20480/1024=20KB
output4: VmSize: 284864 - 284800 = 64KB 5120/1024=5KB
output5: VmSize: 284928 - 284864 = 64KB 65536/1024=64KB
output6: VmSize: 284992 - 284928 = 64KB 16384/1024=16KB
output7: VmSize: 285056- 284992 = 64KB 4096/1024=4KB
output8: VmSize: 285120 - 285056 = 64KB 1024/1024=1KB
output9: VmSize: 285184 - 285120 = 64KB 256/1024=0.25KB
output10: VmSize: 285248 - 285184 = 64KB 16384/1024=16KB
output11: VmSize: 285312- 285248 = 64KB 4096/1024=4KB
output12: VmSize: 285376 - 285312 = 64KB 1024/1024=1KB
output13: VmSize: 285504 - 285376 = 128KB 256/1024=0.25KB
output14: VmSize: 285504 - 285440 = 64KB 256/1024=0.25KB
J6M: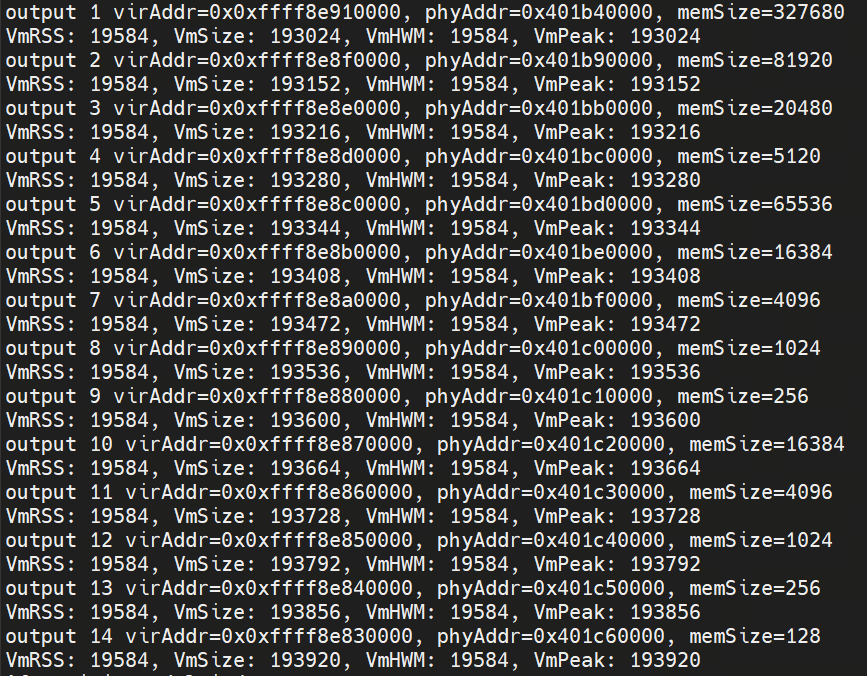
output1: VmSize: 193024 - 192704= 320KB = 327680/1024
output3: VmSize: 193216 - 193152= 64KB = 20480/1024=20KB
由于ARM架构默认采用64KB内核页大小,相比x86的4K页能减少页表条目数并提升TLB命中率。
推理
除开第一次推理外,在推理过程中,系统内存处于稳态,不会发生变化:
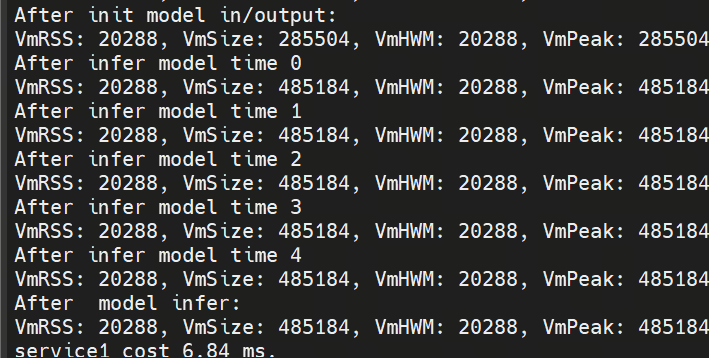
增加的内存:VmSize: 485184 - 285504 = 195MB
增加的内存:VmSize: 485184 - 285504 = 195MB
第一次的模型推理变化主要是由于在调用hbDNNInferV2+hbUCPSubmitTask时,增加的内存一共包含3部分:虚拟窗口,模型任务序列化以及pad内存
虚拟窗口:会受到环境HB_UCP_ENABLE_BPU_BACKEND_CORE_NUM影响,当配置这个后,初始化阶段时会根据配置的core数量减少初始化需要的虚拟内存以及实际推理时的虚拟内存,仅仅减少的虚拟内存占用,并不会减少真实物理内存占用。
虚拟窗口:会受到环境HB_UCP_ENABLE_BPU_BACKEND_CORE_NUM影响,当配置这个后,初始化阶段时会根据配置的core数量减少初始化需要的虚拟内存以及实际推理时的虚拟内存,仅仅减少的虚拟内存占用,并不会减少真实物理内存占用。
模型输入/输出释放
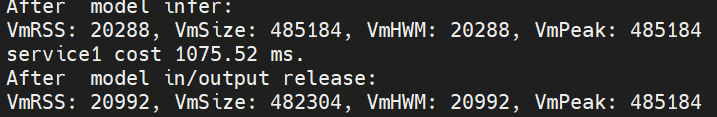
VmSize: 485184 - 482304 = 2880,等于分配的输入输出的总内存,每一步释放的内存就是每个输入输出申请的内存。
模型释放
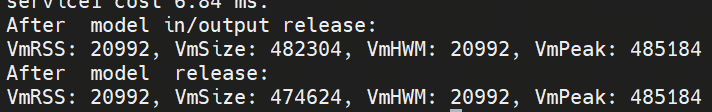
VmSize: 482304 - 474624 = 7680KB
调用模型释放接口后,只会释放hbm文件句柄以及其依赖的东西。
多模型推理情况
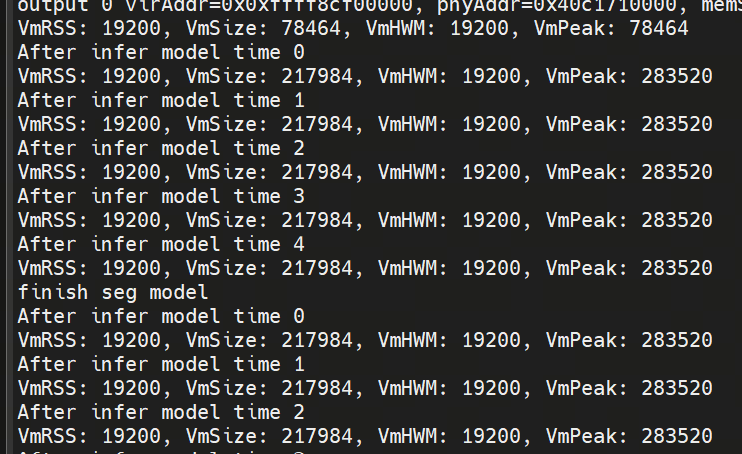
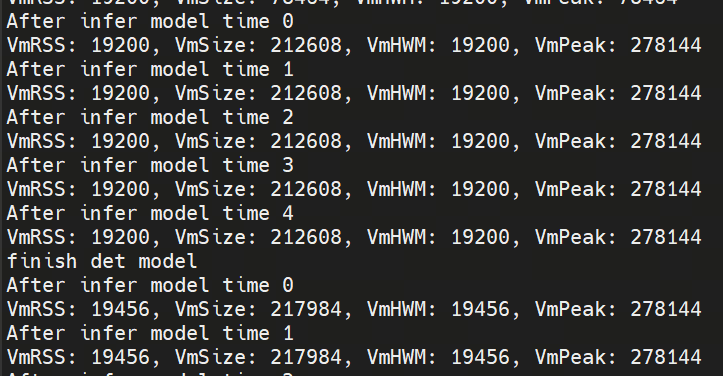
多模型推理时,如果前一个模型推理时申请的张量映射缓冲大于后面的需要的张量映射缓冲,则内存不需要重复申请(UCP内部有复用策略,只要够大就复用)